用语域分析引导大语言模型进行任意风格迁移
摘要
大语言模型(LLM)已展现出强大的跨风格文本改写能力。然而,如何有效利用该能力完成基于示例的任意风格迁移(example-based arbitrary style transfer)——即把输入文本改写为与给定示例风格相匹配的文本——仍是一个未解难题。其中一个关键问题是:如何描述示例的风格,以引导 LLM 产出高质量的改写。本文提出一种基于语域分析(register analysis)的提示方法,引导 LLM 完成该任务。在多个风格迁移任务上的实证评估表明:与既有提示策略相比,我们的提示方法在增强风格迁移强度的同时,能更有效地保留原文含义。
1 引言
文本风格迁移(TST)指在保留含义、流畅性等非风格属性的前提下,将输入文本转换为目标风格(如正式度)(Mir et al., 2019; Krishna et al., 2020; Jin et al., 2022)。TST 有许多下游应用,例如:智能写作助手可帮助用户把文本改写为符合个性化要求(如更专业、更礼貌等)的版本(Jin et al., 2022);其他应用还包括文本简化、文本去毒化、作者身份混淆等(Jin et al., 2022; Mukherjee et al., 2024; Fisher et al., 2024)。
自然语言生成(NLG)与大语言模型(LLM)的进展使得大规模自动化 TST 成为可能(Jin et al., 2022)。面对"更低数据需求、更广风格覆盖"的需求(Jin et al., 2022; Hu et al., 2023),学界日益关注更为一般化的表述——任意风格迁移(arbitrary TST):由 LLM 在推理时把输入文本改写为用户指定的任意风格(Suzgun et al., 2022; Reif et al., 2022; Patel et al., 2024)。Reif et al. (2022) 证明,把任意 TST 框定为"句子改写任务",并用自然语言指令(如 "make this melodramatic")驱动,是有前景的。但这种灵活性把"构造正确提示词"的负担留给了终端用户——这往往需要不透明的提示工程,对非母语者或不熟悉如何用术语表达细微风格者尤为困难。为此,基于示例的任意 TST成为解决方案:在推理时提供若干代表目标风格的示例(exemplars),让 LLM 从示例中推断目标风格,而无需用户显式描述。例如 Patel et al. (2024) 提出 STYLL:先让 LLM 把若干目标风格示例总结为一串开放式风格描述词(如 "clear, concise, persuasive, intelligent"),再用这些描述词改写输入文本。然而,依赖这类开放式描述(无论由用户提供还是模型推断)存在隐患:这些描述词虽有助于让文本"离开"源风格,却不总能保证忠实复现目标风格(Patel et al., 2024);而且,由于风格描述词不受约束,它们可能产生副作用——模糊风格与内容的界线,进而造成意外的语义改变。
为应对上述挑战,我们提出:引导 LLM 使用 Biber 的多维语域分析(MDA)框架来分析示例的风格。我们的建模假设是:Biber 的语域分析提供了一种结构化且有效的方式来生成准确的"目标风格描述词",使 LLM 能在 TST 生成中可靠使用。理由有二:其一,Biber 的语域分析框架在网上广泛可见,并大量用于教育与语言学语境,LLM 在训练中很可能接触过此类分析示例;其二,Biber 的方法论是数据驱动的,基于大规模语料库的实证分析,其关键语域维度在多种语言与网络文本中均被发现(Biber, 1995; Biber & Egbert, 2018),这提示该框架能凸显在 LLM 预训练数据(其中网络文本占很大比例)中显著存在的风格变异。因此,用 Biber 语域分析描述示例,可能产出有理论依据、易于遵循的风格描述词。此外,我们还探究:对比输入与目标示例的风格,是否比仅刻画目标示例的风格效果更好。
本文评估了两种提示变体——一种基于 Biber 语域分析 + 输入-目标风格对比,另一种仅基于语域分析——并在多样化风格迁移任务(作者风格模仿、正式度迁移、文本简化)上与多个基线比较。实证结果表明我们的提示方法提升了迁移质量:(1)风格迁移强度与基线相当或更优;(2)各任务上语义保留均有大幅提升。
主要贡献:
- 提出一种基于语域分析的提示方法,以增强基于示例的任意 TST 的质量;并研究了在不同使用场景下"输入-目标对比"与"仅刻画目标"的影响。
- 在多样化风格迁移任务上的实验表明,该方法提升了改写质量:风格迁移强度相当或更优,语义保留提升显著,说明风格与内容实现了更好的解耦。
2 背景
2.1 语料库语言学中的风格与语域
在语言学中,风格(style)指一个人(如莎士比亚)、或某群体在某一时期或一段时期内的语言习惯(如古英语"英雄体"诗歌)(Crystal & Davy, 1969)。风格反映个体的语言特异(idiosyncrasies),因此应用于争议作者归属判定、司法语言学等领域(Crystal & Davy, 1969; Rudman, 2005; Coulthard et al., 2016)。而语域(register)指与语言的情境使用相关的语言变异,一般由三要素描述:情境语境、语言特征(如词汇与语法特征)、以及前两者之间的功能关系(Biber, 1988; Halliday & Hasan, 1989; Biber & Conrad, 2009)。例如,语域可由口语/书面情境与交际目的来刻画(如私人信件、学术、叙事等)(Biber & Conrad, 2009)。在此视角下,语言特征总是功能性的——它们之所以出现在某语域中,是因为契合该语域的情境与交际语境(Biber & Conrad, 2009)。
分析作者风格的一种框架是计量文体学(stylometry)。典型的文体计量分析对常用词(尤其是功能词,即词汇意义较弱、表达语法关系的词)的相对频率做统计分析(Binongo, 2003; Argamon, 2018; Grieve, 2023)。文体计量在区分作者风格上相当成功(Shakespeare, 2016; Taylor & Egan, 2017),但它缺乏可解释性与语言学理论支撑,在司法调查等需要为法律论证提供依据的场景中并不充分(Grieve, 2023)。另一种框架是语域分析。Grieve (2023) 提出"作者们以微妙不同的语域写作",并证明语域分析识别出的语言变异底层模式与文体计量相同。因此,语域分析是刻画风格变异的强候选框架:它能像文体计量一样有效地区分风格,同时提供更好的可解释性(Grieve, 2023)。
2.2 NLP 中的风格迁移
NLP 中的"风格"。在 NLP 中,风格迁移任务把"语言风格"这一概念宽松地外延到文本的一般属性,如正式度、情感等(Jin et al., 2022)。其中一些属性从语言学视角看并非严格意义上的风格特征。例如,正面 vs. 负面情感与其说是风格属性,不如说更接近内容属性;而正式度与语域的关系比与"风格"更密切。在实践中,风格区分依赖于特定语料库,这限制了 LLM 适应大量未见风格、执行低资源风格迁移的能力。
有监督单风格迁移。有监督单风格迁移指在保留内容的同时改变文本的某一特定风格属性,通常依赖大规模平行风格语料训练模型。例如 Jhamtani et al. (2017) 提出"拷贝增强"的 Seq2Seq 模型,在 Xu et al. (2012) 构建的大规模平行语料上训练,以增强现代英语→莎士比亚风格迁移的内容保留。基于 Transformer 的模型(Vaswani et al., 2017)带来了新动力:如 de Rivero et al. (2021) 在 GYAFC(Rao & Tetreault, 2018)正式度迁移平行语料上微调 GPT-2(Radford et al., 2019),性能提升;Atwell et al. (2022) 构建了基于 Reddit 的"攻击性→非攻击性"平行语料,并提出话语感知机制以降低攻击性并保留含义。
多任务风格迁移。多任务风格迁移旨在让单一模型执行多种风格迁移任务,支持推理时灵活切换风格。早期工作如 Logeswaran et al. (2018) 提出无监督训练框架,可同时修改文本的多个属性并保留内容;Vecchi et al. (2022) 提出分离风格与内容隐空间的学习框架,实现内容保留更好的多风格迁移;Subramanian et al. (2018) 则表明:多任务风格迁移未必需要解耦风格与非风格特征——纠缠模型在无监督或伪监督训练下也能表现良好。虽然多任务风格迁移通过从目标风格文本学习减少了对平行数据的依赖,但仍需要大量非平行、特定风格的数据——除少数常见风格外,这类资源往往不可得。
基于 LLM 的风格迁移。上下文学习(Brown et al., 2020)与指令微调(Ouyang et al., 2022)等技术的进展使 LLM 仅凭自然语言提示与上下文示例即可执行风格迁移,无需任务特定微调。该方向的奠基工作之一是 Reif et al. (2022):用改写指令(如 "make this more comic")提示通用预训练 LLM(如 GPT-3)完成风格迁移。受此启发,Patel et al. (2024) 设计了更精细的任意 TST 方法:提示 LLM 从少量目标风格示例中抽取风格描述词作为改写指令。基于 LLM 的风格迁移大幅降低了对数据与监督的需求,非常适合低资源风格迁移。尽管前景可观,任意 TST 领域仍相对欠探索,在风格可控性、内容保留等方面存在挑战。本文引入基于语域分析的方法来应对这些挑战。
3 方法
在任意 TST 中,目标风格并非由预定义类别集合给出,而是由用户自由指定。这使任务更灵活,也更具挑战:用户如何传达一种可能高度个人化、细微、或模型不熟悉的风格?用户也许感受得到这种风格——"这听起来像我",或"我想让文本听起来像这个例子"——但难以用明确的技术术语描述其复杂性。因此我们采用如下任务形式化:
输入:一段输入文本 \(x^{\mathrm{input}}\),以及一个指示期望风格的风格示例 \(x^{\mathrm{style}}\)。
输出:\(x^{\mathrm{output}}\)——以 \(x^{\mathrm{style}}\) 的风格对 \(x^{\mathrm{input}}\) 的改写,同时保留含义。
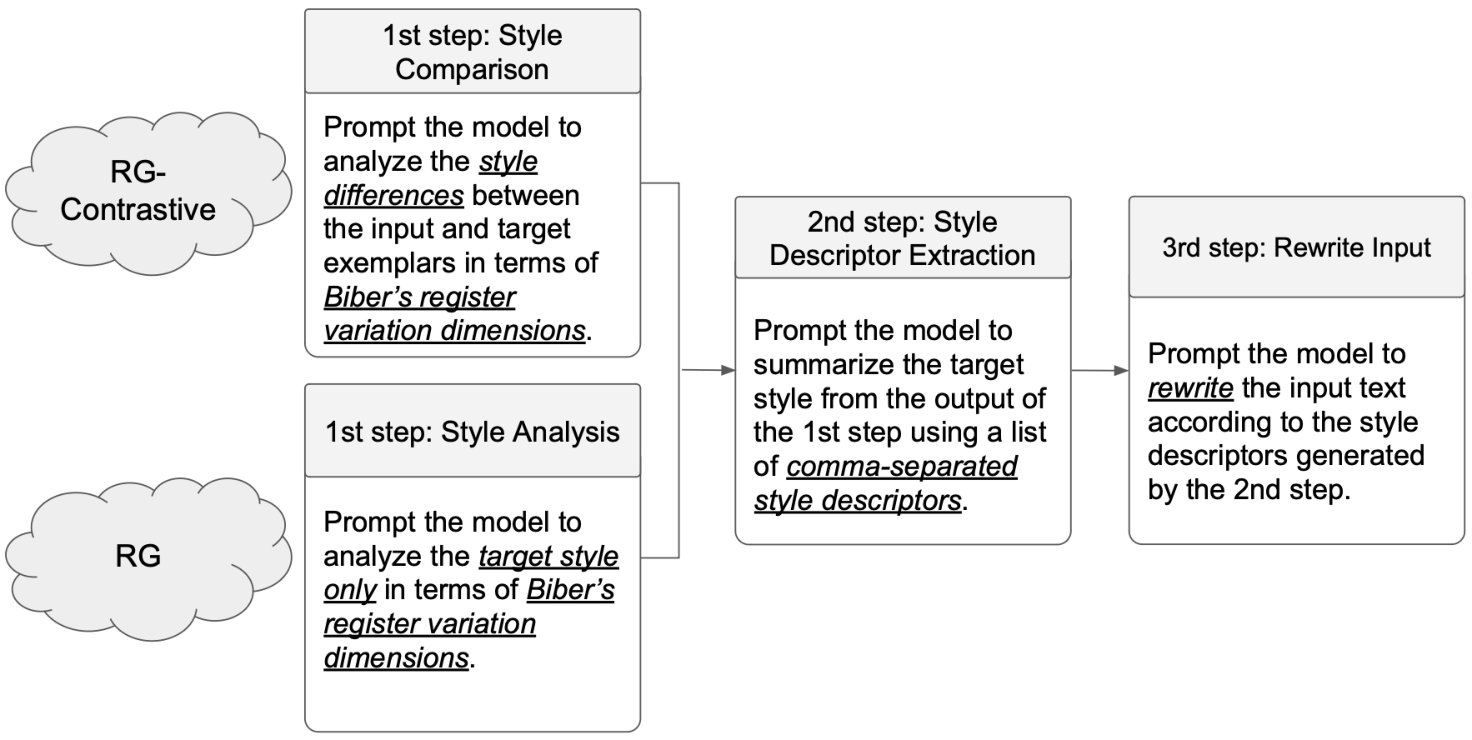
为求解该任务,我们从最直接的方法入手:提示(prompting)。鉴于语域分析可用于刻画、区分与解释作者风格,我们假设:向 LLM 提供基于语域分析的指令,能实现更有效的任意 TST。我们设计了一个三步提示策略引导 LLM 完成基于示例的任意 TST,包含两个变体:
- RG-Contrastive(RG 为 register 的缩写):"语域分析" + "对比输入与目标示例";
- RG:第一个变体去掉对比机制的消融版,仅做"语域分析"。
流程见图 1;实验中使用的完整提示词见附录 A 的表 4。
4 实验设置
本节描述实验设置:任务、共用指标、模型与基线。
4.1 任务
4.1.1 作者风格模仿(Authorship Imitation)
数据集。我们采用 Patel et al. (2024) 的方法与指标构建三个测试集:从 Reddit Million User(MUD)数据集(Khan et al., 2021)的 "test_queries" 与 "test_targets" 划分中分别采样 15 位源作者与 15 位目标作者。MUD 中每位作者有 16 篇帖子。沿用 Patel et al. (2024),构建三个变体:(1)Random(随机):源与目标作者随机选取;(2)Single(单一):源与目标作者的 16 篇帖子全部来自最常见的同一个子版块(subreddit),通过把所有文本限制在同一领域来实现内容控制;(3)Diverse(多样):源与目标作者的 16 篇帖子来自至少 13 个不同子版块,确保作者写作横跨多样领域。目标构建细节见附录 B。
任务指标。我们使用在 MUD 上训练的作者身份嵌入模型 LUAR(Rivera-Soto et al., 2021),把输入、目标与改写文本嵌入"作者身份空间",并计算 Away 与 Towards 两个分数,分别表示改写-输入距离与改写-目标距离:
\[\mathrm{Away}=\frac{1-\cos\bigl(\mathrm{LUAR}(\mathrm{Rewritten}),\ \mathrm{LUAR}(\mathrm{Input})\bigr)}{2}\]
\[\mathrm{Towards}=\frac{1+\cos\bigl(\mathrm{LUAR}(\mathrm{Rewritten}),\ \mathrm{LUAR}(\mathrm{Target})\bigr)}{2}\]
沿用 STYLL(Patel et al., 2024),我们使用互蕴含分数 MIS(Babakov et al., 2022)——一种基于两文本间互蕴含(由自然语言推理 NLI 模型判定)的语义保留指标。为提高语义保留评估的可靠性,另加入两个常用指标:SBERT 相似度(Reimers & Gurevych, 2019)与 METEOR(Banerjee & Lavie, 2005)。
4.1.2 正式度迁移(Formality Transfer)
数据集。使用 GYAFC(Rao & Tetreault, 2018)的测试划分——正式度迁移评估的标准基准,覆盖两个领域:娱乐与音乐(EM)和家庭与关系(FR)。每个领域做两个方向:非正式→正式(I2F)与正式→非正式(F2I)。每个方向从训练划分中选取期望正式度的文本作为供改写系统模仿的目标。细节见附录 B。
任务指标。沿用既有做法(Horvitz et al., 2024),使用在 GYAFC 上微调的现成二分类正式度分类器评估风格迁移准确率(Dementieva et al., 2023),判定阈值取 0.5。语义保留使用 MIS(Babakov et al., 2022)——该文推荐 MIS 在包括复述与正式度迁移的 TST 子任务上尤为成功。同样加入 SBERT 相似度与 METEOR 作为补充指标。
4.1.3 文本简化(Text Simplification)
数据集。在 Cochrane(Devaraj et al., 2021)测试划分上评估——一项段落级简化任务,目标是把医学摘要简化为通俗语言摘要(PLS)。我们从 Cochrane 训练划分中选取 PLS 文本作为供改写系统模仿的目标。细节见附录 B。
任务指标。沿用既往工作(Alva-Manchego et al., 2020; Devaraj et al., 2021; Laban et al., 2021):简化度用(1)Flesch-Kincaid 年级水平 FKGL(Kincaid, 1975)——把段落难度换算为美国学校年级的可读性测试;(2)自动可读性指数 ARI(Smith & Senter, 1967)——类似 FKGL,估计理解文本所需的美国年级水平。内容保留用(1)ROUGE(Lin, 2004)——基于召回率的摘要评估指标组,报告 ROUGE-1/2/L(分别衡量系统输出与参考文本的一元组、二元组与最长公共子序列重叠);(2)BLEU(Papineni et al., 2002)——基于 n-gram 参考的机器翻译指标,也常用于简化系统评估(Devaraj et al., 2021)。整体改写质量用 SARI(Xu et al., 2016)——衡量简化系统在 keep / delete / add 三种关键编辑操作上的表现,SARI 被证明与人类判断相关性良好(Xu et al., 2016; Agrawal & Carpuat, 2024)。FKGL 与 ARI 越低表示越简单;ROUGE、BLEU、SARI 取值 0–1,越高越好。
4.2 指标
风格迁移。除 4.1 中各任务的任务指标外,我们还使用两种风格表示来评估改写文本对精确目标风格的模仿程度:(1)StyleCAV(Wegmann et al., 2022)——以"内容无关的风格表示"为目标的通用风格嵌入模型,在 Reddit 话语上带内容控制地训练,在作者验证(AV)任务上测试;(2)Biber 的 MDA(Biber, 1988)——由于我们的方法正是在 Biber MDA 指导下引导 LLM 改写的,我们检验输出在真实 Biber MDA 表示空间中与目标的接近程度。我们按 Grieve (2023) 的做法对数据集与系统输出执行 Biber MDA(表示构建与推断流程见附录 D)。分别基于 StyleCAV 与 Biber MDA 嵌入计算 Away/Towards 分数(定义同 4.1.1)。
语义保留。见 4.1 各任务的任务指标。
流畅性。沿用既有做法(Horvitz et al., 2024; Bao & Carpuat, 2024),使用在 COLA 数据集上训练的语法可接受性评估模型(Warstadt et al., 2019; Morris et al., 2020)。
目标重叠(Target Overlap)。为惩罚"把目标内容抄进输出"的行为(这种行为不可取,且可能欺骗风格指标、让系统看起来很好地模仿了目标风格),我们测量系统输出与目标之间的内容重叠,以目标为参考报告系统输出的 ROUGE-1/2/L。
4.3 模型
所有子任务均使用 Llama3.2-3B-Instruct。选择该模型是因为其定位为"类助手对话与智能体应用(如知识检索与摘要、移动端 AI 写作助手、查询与提示改写)"(Meta AI, 2024);指令微调使模型能够遵循显式提示,并被发现在大量未见任务上显著提升零样本性能(Ouyang et al., 2022; Wei et al., 2022; Chung et al., 2022; Wang et al., 2022);其较小规模也适合算力受限场景。我们想探究:更小的模型是否也能受益于我们的提示方法——这与 Reif et al. (2022) 采用超大模型(如 175B 的 GPT-3)形成对比。此外,在作者风格模仿子任务上追加 Llama3.1-8B-Instruct,考察中等规模模型对提示方法的响应以及跨模型的可泛化模式。受算力限制,未实验 Llama 家族更大模型(70B 及以上)。模型取自 HuggingFace,除 max_new_tokens 设为 1024(以容纳更长输出)外均用默认参数。模型与指标模型的下载链接见附录 C 表 5。
4.4 基线
我们与表 1 所列基线对比,全部实验均为零样本设置。完整提示词见附录 A 表 4。
表 1:实验基线总览。
| 方法 | 描述 |
|---|---|
| Copy | 朴素方法:原样复制源输入文本。 |
| Target | 朴素方法:把目标文本直接作为改写结果。 |
| Gold | 伪方法:复制参考文本(若有);存在多条参考文本时随机选一条作为输出。仅作为上限参考。 |
| Simple | 单行简单提示:指示 LLM 改写输入以模仿目标示例的作者风格。 |
| STYLL(Patel et al., 2024) | 基于示例的任意 TST 方法:先提示模型把输入改写为中性风格,再把目标风格总结为风格描述词列表,最后用这些描述词改写"中性版输入"。 |
5 结果
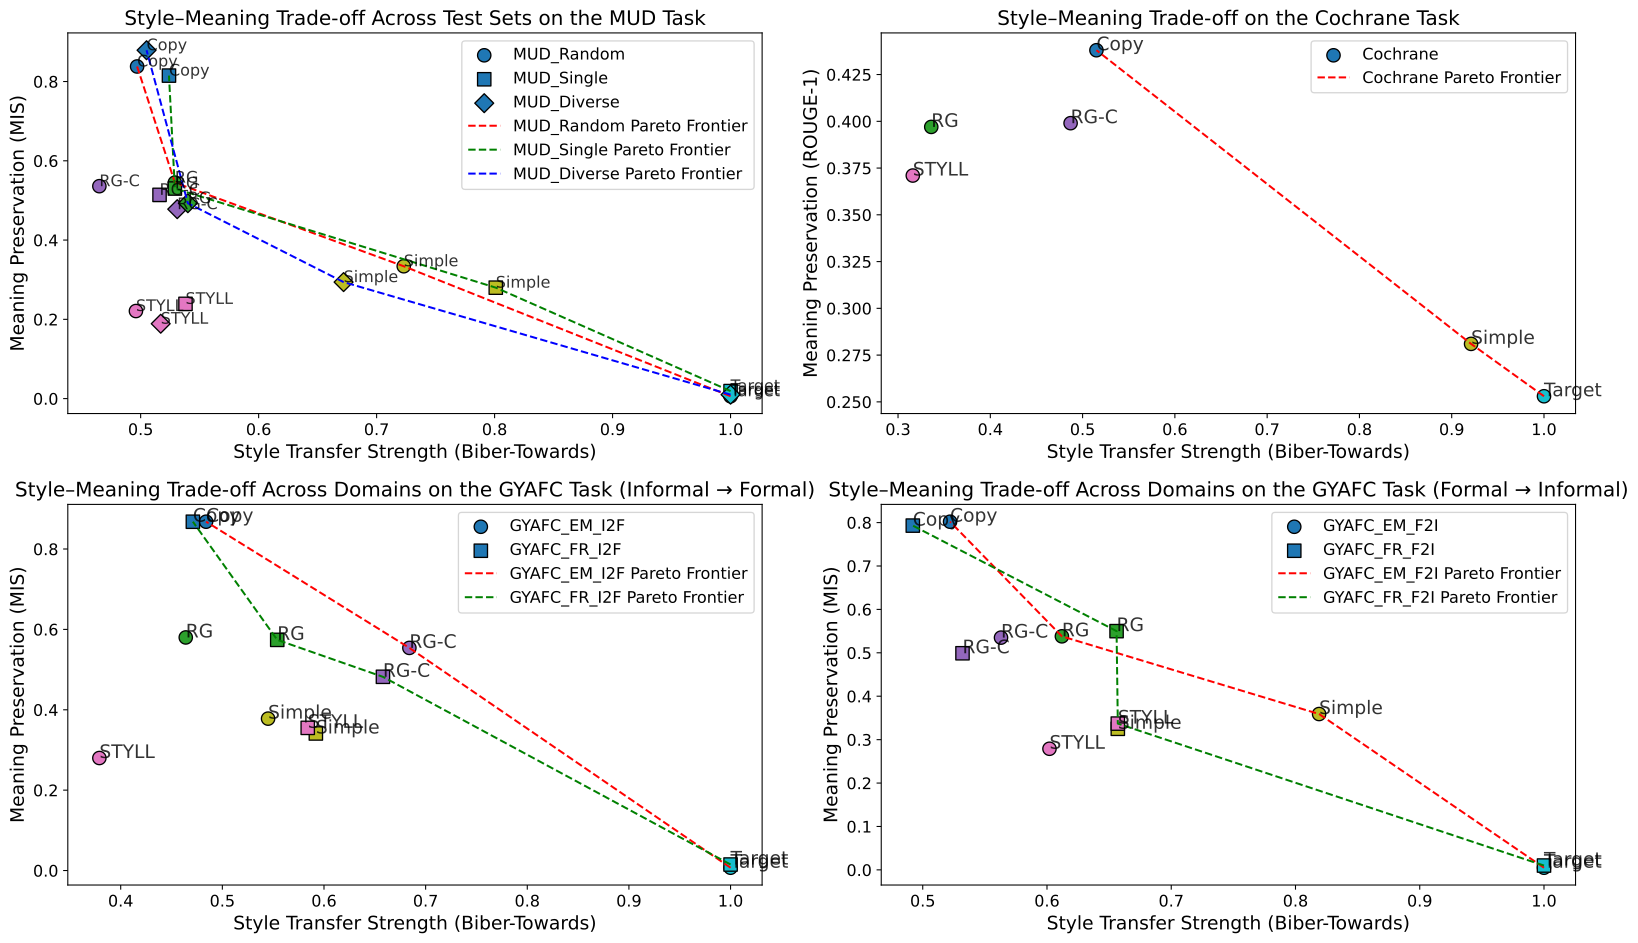
对于基于示例的任意 TST,为研究本任务的核心难题——风格迁移强度与语义保留之间的权衡,我们绘制了各改写系统的帕累托前沿:横轴为风格迁移强度(用 Biber MDA 表示的 Towards 度量),纵轴为语义保留(MUD 与 GYAFC 用 MIS、Cochrane 用 Rouge-1),模型为 Llama3.2-3B-Instruct(见图 2)。对每个任务,帕累托前沿展示了"没有其他系统能在两个目标上同时更优"的系统集合。可以观察到一个符合预期的现象:朴素基线 Copy 与 Target 始终位于帕累托前沿上,因为它们分别在语义保留与风格模仿上达到最优。
在受评系统中,我们的方法在各任务上持续表现强劲。在 MUD 作者风格模仿任务上,RG 在所有数据划分上都位于帕累托前沿,在风格强度与语义保留之间取得良好平衡;RG-Contrastive 略逊。在 GYAFC 上,趋势随迁移方向而异:I2F 方向,RG-Contrastive 在 EM 与 FR 两个领域都位于帕累托前沿,风格迁移强度远高于 RG;而 F2I 方向恰好相反——RG 在跨领域上位于帕累托前沿,风格强度优于 RG-Contrastive。这种性能差异提示了两者的不同适用场景。我们猜测出现这种"翻转趋势"的原因是:GYAFC 中的"正式"目标是相对输入文本而言的正式,而非绝对意义的正式。I2F 实验中我们观察到 RG 与 STYLL 倾向于生成 "informal" "causal"(原文如此)之类的描述词,把模型引向错误方向,而 RG-Contrastive 通常能判对。反之,GYAFC 中的"非正式"目标大多是绝对意义上的非正式(大量俚语、缩写等),因此 RG 本身足够,而对比机制反而可能混淆模型。在 Cochrane 上,RG 系列未进入帕累托前沿;RG-Contrastive 优于 RG 但不及 Copy——它把输入的复合风格略微推得更远离目标。这可能因为 Cochrane 的输入与目标存在显著的基线相似性(两者分别是医学摘要的原文与简化版,同属"技术性"语域),因此对输入风格的小幅扰动可能无意中使其更远离目标风格。例如 RG 与 STYLL 常把目标风格误判为 "technical" 而走错方向,RG-Contrastive 有时能判定目标相对输入是 "informal",方向正确但可能过冲——这反映了在风格空间中精确定位目标位置的内在困难,尤其当目标风格处于中间位置、而非一个鲜明的风格端点时。
相比之下,STYLL——当前最强的零/少样本基于示例的任意 TST 方法——在各任务上始终是次优选择(未进帕累托前沿,且除 GYAFC_FR_F2I 外常被 RG-Contrastive/RG 支配):其风格迁移强度充其量与我们相当、常常更差,而语义保留则始终大幅落后。令人意外的是,Simple 频繁出现在帕累托前沿,风格强度甚至超过更精细的方法(STYLL、RG 系列)。但这可能并非真正的风格迁移,而是"把目标内容抄进改写结果"导致的虚高。从表 2(各系统跨任务的效用分数汇总)可见,Simple 的 Overlap Rouge-1 常比 RG 系列与 STYLL 高出一个数量级,在 Cochrane 上甚至超过 0.8——表明存在相当高程度的目标内容抄袭,违背风格迁移的初衷(在 Cochrane 上尤其如此)。Simple 在 MUD 与 4 个 GYAFC 划分中的 3 个上,COLA 分数也远低于 RG 系列与 STYLL——在某种程度上类似 Target(其低语言可接受性可预期,因为 MUD 与 GYAFC 的每个目标都是多篇语义与逻辑上不相关文本的拼接),而这可能正是抄袭行为所致。
表 2:各改写系统在 MUD、GYAFC、Cochrane 任务上的目标重叠(Target Overlap,以 Rouge-1 度量,越低越好)与语法可接受性(COLA,越高越好);模型为 Llama-3.2-3B-Instruct。粗体为非朴素系统(Simple、STYLL、RG-Contrastive、RG)中的最优值。
| 系统 | MUD(Overlap Rouge-1 ↓) | GYAFC(Overlap Rouge-1 ↓) | Cochrane | |||||
|---|---|---|---|---|---|---|---|---|
| Random | Single | Diverse | EM_I2F | EM_F2I | FR_I2F | FR_F2I | Overlap Rouge-1 ↓ | |
| Copy | 0.075 | 0.051 | 0.070 | 0.234 | 0.299 | 0.141 | 0.088 | 0.234 |
| Target | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| Gold(伪) | – | – | – | 0.253 | 0.087 | 0.089 | 0.095 | 0.253 |
| Simple | 0.343 | 0.426 | 0.382 | 0.864 | 0.310 | 0.127 | 0.104 | 0.864 |
| STYLL | 0.145 | 0.119 | 0.148 | 0.239 | 0.056 | 0.099 | 0.090 | 0.239 |
| RG-Contrastive | 0.107 | 0.070 | 0.108 | 0.251 | 0.046 | 0.104 | 0.094 | 0.251 |
| RG | 0.110 | 0.077 | 0.113 | 0.234 | 0.090 | 0.095 | 0.086 | 0.234 |
| 系统 | MUD(COLA ↑) | GYAFC(COLA ↑) | Cochrane | |||||
|---|---|---|---|---|---|---|---|---|
| Random | Single | Diverse | EM_I2F | EM_F2I | FR_I2F | FR_F2I | COLA ↑ | |
| Copy | 0.783 | 0.679 | 0.754 | 0.746 | 0.933 | 0.790 | 0.921 | 0.969 |
| Target | 0.067 | 0.133 | 0.067 | 0.253 | 0.000 | 0.520 | 0.042 | 0.965 |
| Gold(伪) | – | – | – | 0.925 | 0.743 | 0.944 | 0.822 | 0.967 |
| Simple | 0.537 | 0.446 | 0.532 | 0.727 | 0.517 | 0.916 | 0.745 | 0.967 |
| STYLL | 0.982 | 0.956 | 0.978 | 0.970 | 0.951 | 0.989 | 0.987 | 1.000 |
| RG-Contrastive | 0.960 | 0.951 | 0.960 | 0.983 | 0.944 | 0.990 | 0.986 | 1.000 |
| RG | 0.949 | 0.923 | 0.952 | 0.929 | 0.939 | 0.977 | 0.972 | 0.998 |
表 3:GYAFC 与 Cochrane 上的通用风格迁移评估(Llama-3.2-3B-Instruct)。左:GYAFC 以准确率(↑)与语义保留(MIS ↑)评估。右:Cochrane 以可读性(FKGL、ARI ↓)、编辑质量(SARI ↑)与语义保留(Rouge-1 ↑)评估。粗体为非朴素系统中的最优值。
| 系统 | GYAFC | Cochrane | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| EM_I2F Acc↑ | EM_I2F MIS↑ | EM_F2I Acc↑ | EM_F2I MIS↑ | FR_I2F Acc↑ | FR_I2F MIS↑ | FR_F2I Acc↑ | FR_F2I MIS↑ | FKGL↓ | ARI↓ | SARI↑ | Rouge-1↑ | |
| Copy | 0.064 | 0.868 | 0.024 | 0.802 | 0.072 | 0.868 | 0.046 | 0.793 | 12.81 | 15.26 | 0.418 | 0.438 |
| Target | 0.999 | 0.007 | 0.887 | 0.005 | 0.996 | 0.015 | 0.845 | 0.010 | 11.68 | 13.86 | 0.346 | 0.253 |
| Gold(伪) | 0.921 | 0.877 | 0.830 | 0.787 | 0.937 | 0.877 | 0.850 | 0.780 | 11.49 | 13.66 | 0.982 | 1.000 |
| Simple | 0.476 | 0.378 | 0.869 | 0.359 | 0.553 | 0.341 | 0.820 | 0.325 | 11.76 | 13.95 | 0.353 | 0.281 |
| STYLL | 0.554 | 0.280 | 0.533 | 0.279 | 0.641 | 0.355 | 0.500 | 0.337 | 13.61 | 15.53 | 0.382 | 0.371 |
| RG-Contrastive | 0.886 | 0.554 | 0.482 | 0.535 | 0.899 | 0.482 | 0.396 | 0.499 | 11.47 | 13.58 | 0.390 | 0.399 |
| RG | 0.347 | 0.580 | 0.707 | 0.538 | 0.423 | 0.574 | 0.647 | 0.550 | 14.55 | 17.16 | 0.374 | 0.397 |
表 3 汇总了下游任务主要维度上的风格迁移强度(如有:GYAFC 为正式度,Cochrane 为简单度)。在 GYAFC(I2F)上,RG-Contrastive 取得最佳风格迁移准确率,与其在该任务上明显的模仿优势一致;在 GYAFC(F2I)上,Simple 领先,RG 的准确率居第二,大幅领先 STYLL。值得注意的是:在 MIS 所指示的语义保留上,两个 RG 变体对 STYLL 与 Simple 均有明显优势(如 EM_I2F 上 RG-Contrastive 与 Simple 的 MIS 分别为 0.554 与 0.378)。在 Cochrane 上,RG-Contrastive 四项指标(FKGL、ARI、SARI、Rouge-1)全部领先:尽管在"精确复现目标风格"上略逊,它在下游目标上表现出色——确实把输入推向了简单度谱的"简单"一端,整体简单度甚至优于 Gold(由 FKGL 与 ARI 指示)。总体而言,这表明 RG-Contrastive/RG 相比 STYLL 等方法,能很好地抓住目标文本的主要风格维度并在这些维度上完成迁移。尽管 RG 系列未必总能捕捉目标风格中无穷的复合细节(这本身就很难),但当存在显著的主要风格维度时,它能够很好地服务于实际下游目标。
其余指标呈现相似趋势;完整实验结果(Llama3.2-3B-Instruct 在 MUD、GYAFC、Cochrane 上,以及 Llama3.1-8B-Instruct 在 MUD 上)见附录 E。Llama3.1-8B-Instruct 在 MUD 上呈现与 Llama3.2-3B-Instruct 相似的系统间趋势:RG 系列在风格强度与语义保留间取得良好平衡,在语义保留上优势明显,RG 常在两个目标上都支配 STYLL。Simple 仍领先 Towards 分数,但目标重叠显著更高——表明其更多是"抄目标"的非真实改写——且当 Target 本身存在"拼接多文本"问题时,其语言可接受性也偏低。这说明我们在 Llama3.2-3B-Instruct 上观察到的模式并非该模型独有,而是可泛化到其他模型。与 3B 模型相比,8B 模型整体语义保留更好(MIS 等),在 Random 与 Single 划分上风格强度略降(Towards-Biber 等),在 Diverse 划分上风格强度略有提升——说明稍大的模型能在语义保留上获益(未必在风格强度上),并可能在跨领域风格模仿(输入与目标来自不同领域)上有优势。
6 定性分析
定性示例。为直观理解改写系统的行为,我们考察其生成输出。附录 F 表 9 给出 MUD 任务上的若干(输入、目标、输出)示例:系统需要把输入 "Verratti is practically untouchable. He's signing an extension every year or so and PSG won't sell for even a €100m." 改写成不同目标("…Aaaaanndd you are all on a list…"、"…Jesus Christ, Cesaro…" 等)的风格。在这些例子中,目标普遍比输入更随意、更口语化。RG 系列成功捕捉到这一转变:输出带有口头填充语("oh man"、"i mean")、小写("i mean"、"no way")、以及 "nope"、"lol" 等表达。语义上,RG 系列在各目标间准确保留了关键含义("untouchable"、"每年续约"、"PSG 无论如何不会放走 Verratti")。STYLL 也成功捕捉了向更随意风格的转变,但引入了更大的语义失真——例如添加了输入中不存在的内容("locking down new deals"、"bread and butter of the team"、"legend"、"glue" 等)。事实上,STYLL 添加的细节虽看似合理、或可从输入语境中推断,却并非原文显式存在。因此,对语义保留要求严格的任务,RG 类方法更合适。Simple 的语气转变较轻微,输出中偶尔出现口语化、随意表达,但也偶尔引入目标中的内容("Log in you … ones!"),这是不希望出现的行为。
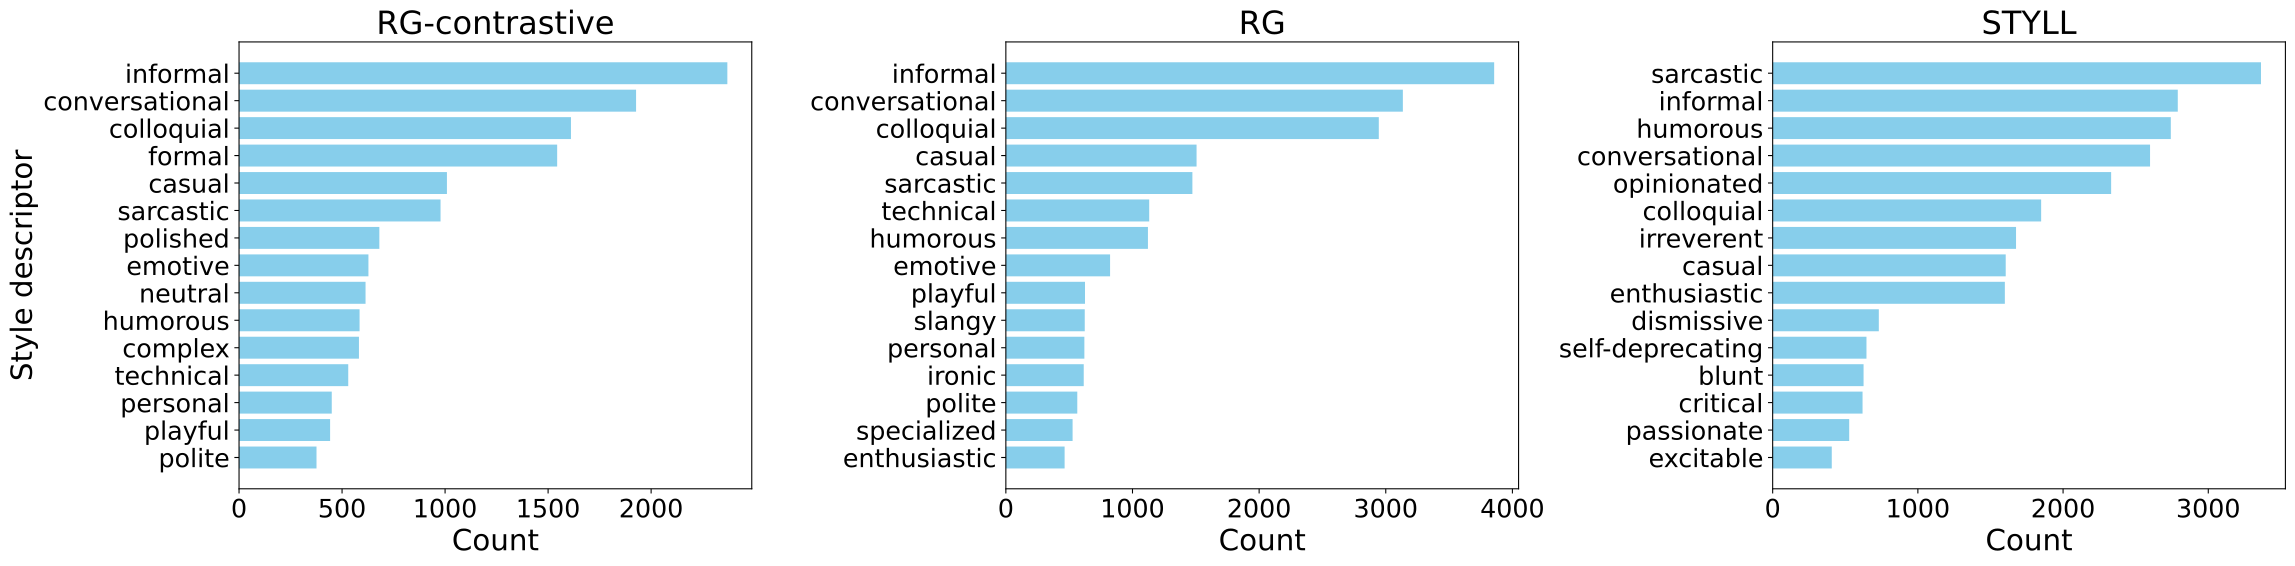
风格描述词分析。对 RG 系列与 STYLL 而言,中间步骤生成的风格描述词是对目标示例的关键刻画,决定了风格迁移的方向。STYLL 让 LLM 以开放式方式解读"风格";而 RG 类提示则指示模型以 Biber 语域分析为指引来解读"风格"。为理解不同解读方式是否影响描述词的性质,我们对各方法(RG-Contrastive、RG、STYLL)生成的风格描述词分布做统计分析。图 3 展示 MUD_Random 数据集上各系统最高频的 15 个风格描述词。可以看到:两个 RG 变体最高频的 3 个描述词均为 "informal"、"conversational"、"colloquial"——与 MUD(源自 Reddit 的数据集)的随意、口语化特质吻合;而 STYLL 的前三是 "sarcastic"、"informal"、"humorous",其中两个与 RG 不同。此外,RG 与 STYLL 各自还会生成其"风格解读"独有的描述词:例如 STYLL 的前 15 中包含 "opinionated"、"irreverent"、"dismissive"、"self-deprecating" 等,而 RG 的前 15 包含 "polished"、"emotive"、"playful"、"technical"、"polite" 等。整体上,STYLL 更倾向产出情感化、语气导向的风格描述词——这类词可能意味着语气或意图的转变,因而更可能改变原意;而 RG 的风格描述词更局限在语域空间内,引导模型进行对语义影响最小的风格调整。
7 结论
本文提出一种基于语域分析的提示方法,引导 LLM 完成基于示例的任意 TST。我们的方法不依赖对"风格"的开放式解读,而是指示模型在语域空间内推理风格变异。跨多个风格迁移任务的实验表明,本方法提升了改写质量,尤其在语义保留方面。定性分析进一步显示,本方法生成的风格描述词更贴近语域,对意图与语气的改动最小,从而降低了意外改变语义的风险。总体而言,我们的提示策略在增强风格控制的同时,保持了高于现有方法的语义准确性。
致谢(节选):感谢马里兰大学 CLIP 实验室 Zoey (Dayeon) Ki、HyoJung Han、Kartik Ravisankar 的反馈。本研究部分受 ODNI / IARPA HIATUS 项目(合同号 2022-22072200006)资助。
伦理声明(节选):我们注意到该技术可能被滥用于针对作者归属(AA)与作者验证(AV)系统的冒名攻击以及虚假信息传播。我们认为收益大于风险:该技术增强低资源场景的风格迁移、支持个性化写作辅助与在线用户隐私保护,并可作为评估 AA/AV 系统对抗鲁棒性的试验台。我们倡导负责任地使用:鼓励出于创意、教育或研究目的的基于风格的生成,但在身份敏感或官方场景中应适当监管,并可采用使用披露以保证透明与问责。
附录 A:完整提示词
表 4:实验中 Simple、STYLL、RG-Contrastive、RG 的完整提示词。表中 [neural paraphrase / style comparisons / style analysis] 为第 1 步的模型输出,[style descriptors] 为第 2 步的模型输出。STYLL 采用 Patel et al. (2024) 的提示词,仅做少量调整以适配本文的零样本设置。
(提示词保持英文原文,便于直接使用;中文为对照说明。)
Simple(单行基线)
Here is the target text [target text] Rewrite [input text] into the authorship style of the target text. Strictly output only the rewritten text without any other content.
译文:这里是目标文本 [target text]。请把 [input text] 改写为目标文本的作者风格。只输出改写后的文本,不要输出任何其他内容。
STYLL(三步)
#1  Source text: Passage: [source text] Paraphrase the passage in a simple neutral style.
#2  Passage: [target text] List some adjectives, comma-separated, that describe the writing style of the author of this passage. Strictly output only the style descriptors without any other content.
#3  Here is a text: [neural paraphrase] Here is a rewrite of the text that is more [style descriptors]. Strictly output only the rewritten text without any other content.
译文:#1 把源文本改写为简单的中性风格 → #2 列出描述目标文本作者写作风格的形容词(逗号分隔)→ #3 用"更 [风格描述词]"的要求改写中性文本。
RG-Contrastive(三步:语域对比)
#1  Source text: [source text] Target text: [target text] How does the target text differ from the source text in authorship style in terms of dimensions of register variation according to Douglas Biber?
#2  Style comparisons: [style comparisons] List some adjectives, comma-separated, that describe the writing style of the author of the target text. Strictly output only the style descriptors without any other content.
#3  Here is a text: [source text] Rewrite the text to be more [style descriptors]. Strictly output only the rewritten text without any other content.
译文:#1 按 Douglas Biber 的语域变异维度,目标文本相对源文本在作者风格上有何差异?→ #2 根据该对比列出目标作者的写作风格形容词 → #3 把源文本改写得更 [风格描述词]。
RG(三步:仅分析目标语域)
#1  Passage: [target text] Analyze the authorship style of this passage in terms of dimensions of register variation according to Douglas Biber.
#2  Style analysis: [style analysis] List some adjectives, comma-separated, that describe the writing style of the author of the target text. Strictly output only the style descriptors without any other content.
#3  Here is a text: [source text] Rewrite the text to be more [style descriptors]. Strictly output only the rewritten text without any other content.
译文:#1 按 Biber 语域变异维度分析该段落的作者风格 → #2 列出目标作者的写作风格形容词 → #3 把源文本改写得更 [风格描述词]。
附录 B:目标(风格样例)构建
作者风格模仿。推理时,每位源作者的每篇输入文本(每位源作者有 16 篇)与每位目标作者配对,共 \(16\times15\times15=3600\) 个配对。每个配对对应的风格迁移中,目标作者的 16 篇文本被拼接在一起,作为该目标风格的示例,模型需把输入改写为其风格。
正式度迁移。为避免意外向改写系统暴露"标准答案",目标选自 GYAFC 数据集的训练划分。GYAFC 文本为句子级,可能过短、不足以提供足够的语言学信息;因此对每段输入文本,我们从目标池中随机抽取若干句拼接为段落级目标示例(沿用 MUD 评估集的构建方式)。目标与对应输入领域相同、正式度相反。例如,对 "EM" 领域的一段正式输入,从 GYAFC 的 EM-train-informal 划分中随机选取 16 句拼成段落级目标,以在模型推理时提供风格信息。
文本简化。同样为避免暴露"标准答案",从 Cochrane 训练划分随机选取通俗语言摘要文本作为目标。与 GYAFC 不同,Cochrane 文本为段落级,单篇长度即足以作为目标,无需拼接。
附录 C:模型资源
表 5 列出实验中使用的预训练模型链接,均公开可经 Hugging Face Model Hub 访问。
表 5:实验所用预训练模型链接。
| 模型 | 链接 |
|---|---|
| Llama3.2-3B-Instruct | https://huggingface.co/meta-llama/Llama-3.2-3B-Instruct |
| Llama3.1-8B-Instruct | https://huggingface.co/meta-llama/Llama-3.1-8B-Instruct |
| LUAR | https://huggingface.co/rrivera1849/LUAR-MUD |
| SBERT | https://huggingface.co/sentence-transformers/all-MiniLM-L6-v2 |
| 正式度分类器(DeBERTa) | https://huggingface.co/s-nlp/deberta-large-formality-ranker |
| StyleCAV | https://huggingface.co/AnnaWegmann/Style-Embedding |
| COLA | https://huggingface.co/textattack/roberta-base-CoLA |
附录 D:Biber MDA 风格表示的实现细节
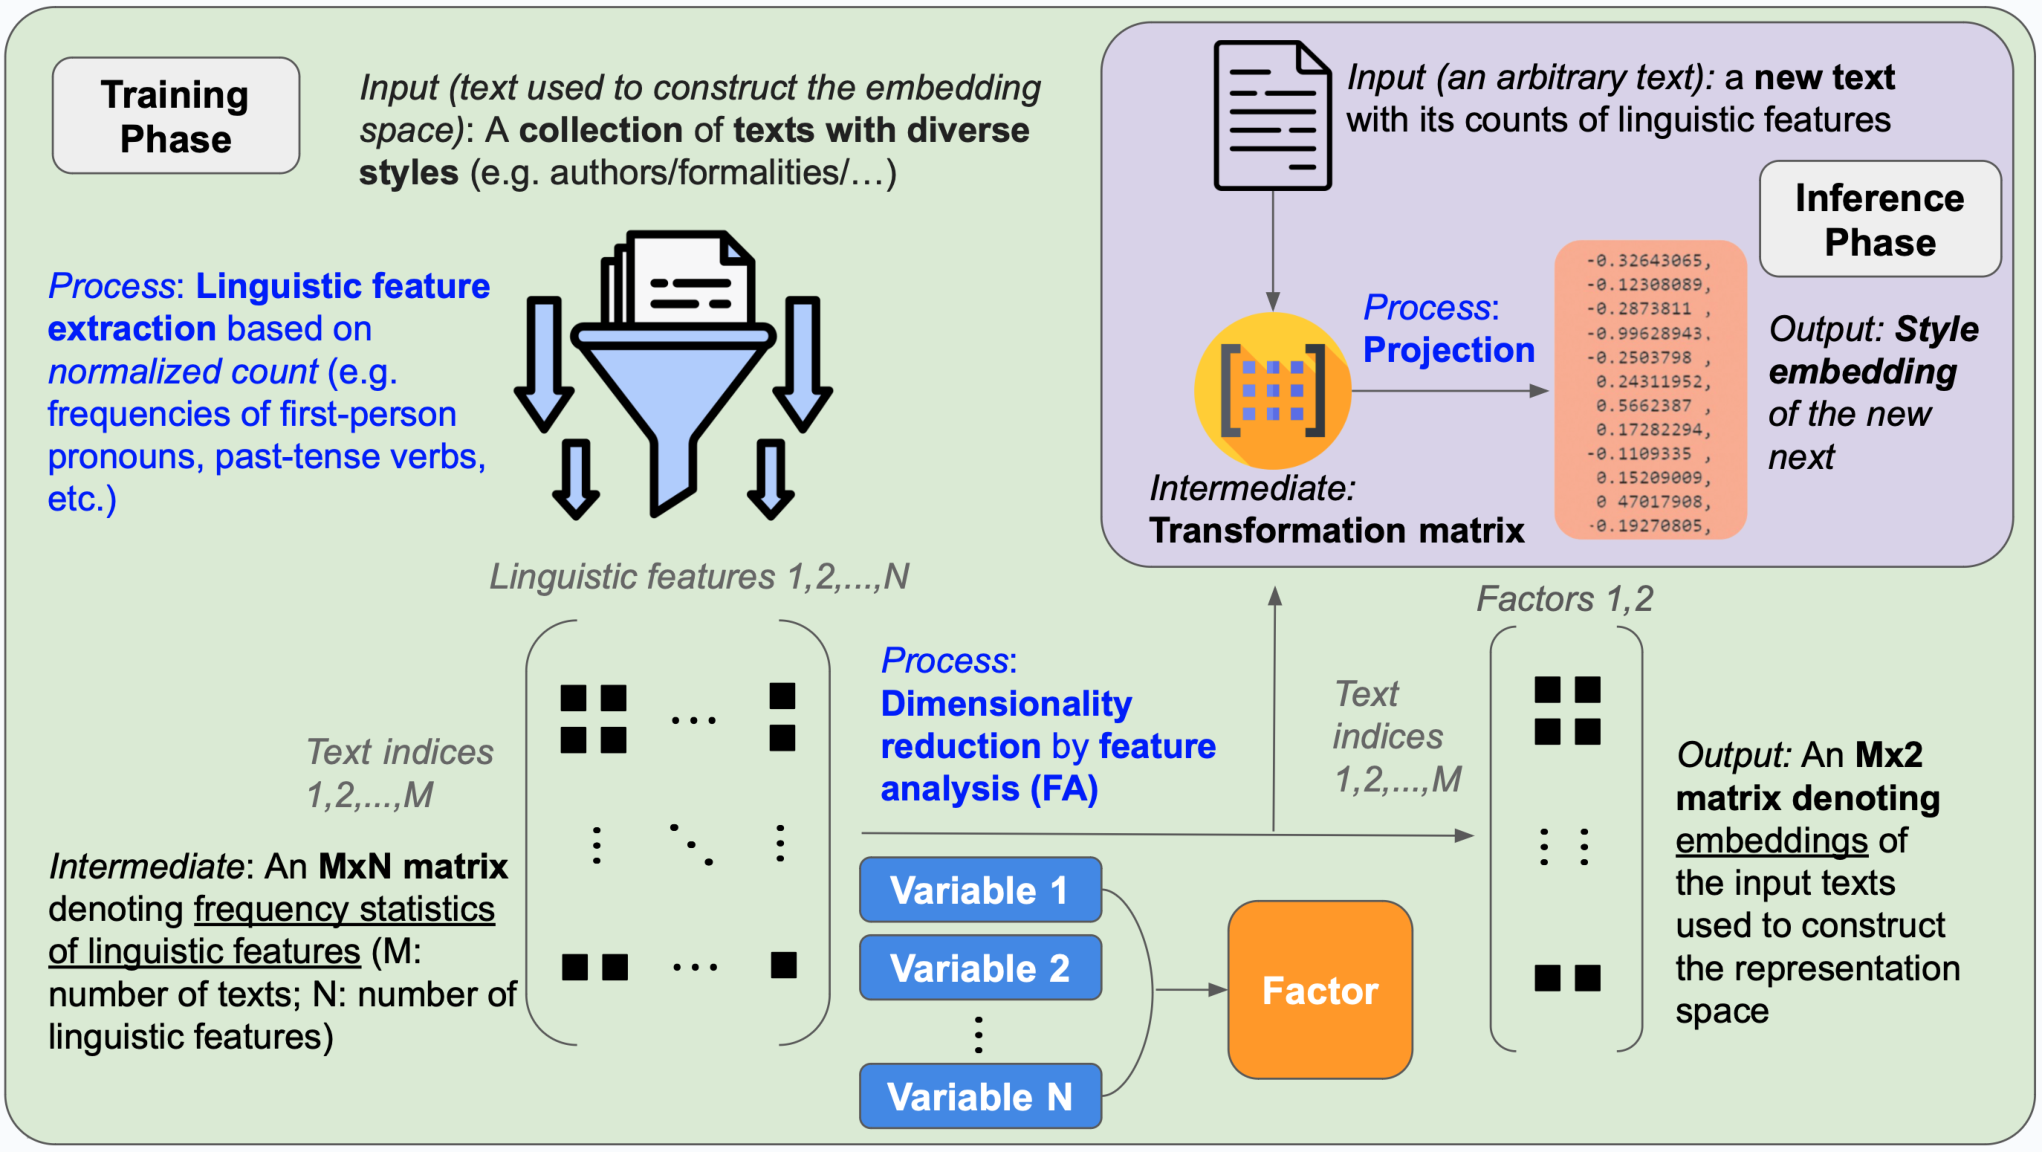
Biber MDA 表示的训练与推断阶段见图 4。我们为每个任务各训练一个 Biber MDA 表示(MUD、GYAFC、Cochrane)。每个任务的训练语料涵盖该任务中多样的风格(MUD 为作者风格、GYAFC 为正式度、Cochrane 为简单度),数据划分如下:
- MUD:validation-queries、validation-targets。
- GYAFC:EM-train-formal、EM-train-informal、FR-train-formal、FR-train-informal。
- Cochrane:train-original、train-simplified。
附录 E:完整实验结果
E.1 作者风格模仿(MUD)
表 6:不同改写系统在 MUD 任务上的评估结果(分别使用 Llama-3.2-3B-Instruct 与 Llama-3.1-8B-Instruct)。粗体为非朴素系统(Simple、STYLL、RG-C、RG)中的最优值。RG-C 即 RG-Contrastive。指标列:LUAR 的 Away/Towards、MIS、Sbert、Meteor、COLA、StyleCAV 的 Away/Towards、Biber 的 Away/Towards、与目标的 Overlap Rouge-1/2/L(↓)。
| Away LUAR | Towards LUAR | MIS | Sbert | Meteor | COLA | Away StyleCAV | Towards StyleCAV | Away Biber | Towards Biber | Ov. R-1↓ | Ov. R-2↓ | Ov. R-L↓ | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Random 划分 | ||||||||||||||
| Naive | Copy | 0.000 | 0.617 | 0.838 | 1.000 | 0.994 | 0.783 | 0.000 | 0.544 | 0.000 | 0.497 | 0.075 | 0.005 | 0.045 |
| Llama3.2-3B-Instruct | Simple | 0.269 | 0.757 | 0.334 | 0.475 | 0.471 | 0.537 | 0.349 | 0.731 | 0.340 | 0.723 | 0.343 | 0.279 | 0.314 |
| STYLL | 0.330 | 0.612 | 0.221 | 0.490 | 0.222 | 0.982 | 0.368 | 0.522 | 0.457 | 0.496 | 0.145 | 0.018 | 0.078 | |
| RG-C | 0.278 | 0.604 | 0.536 | 0.647 | 0.338 | 0.960 | 0.369 | 0.473 | 0.425 | 0.465 | 0.107 | 0.009 | 0.061 | |
| RG | 0.272 | 0.607 | 0.545 | 0.661 | 0.365 | 0.949 | 0.333 | 0.530 | 0.362 | 0.529 | 0.110 | 0.010 | 0.062 | |
| Llama3.1-8B-Instruct | Simple | 0.250 | 0.732 | 0.451 | 0.580 | 0.565 | 0.602 | 0.340 | 0.731 | 0.292 | 0.672 | 0.280 | 0.211 | 0.247 |
| STYLL | 0.324 | 0.632 | 0.261 | 0.548 | 0.235 | 0.981 | 0.369 | 0.534 | 0.443 | 0.491 | 0.178 | 0.021 | 0.089 | |
| RG-C | 0.282 | 0.611 | 0.578 | 0.654 | 0.346 | 0.969 | 0.342 | 0.495 | 0.434 | 0.483 | 0.140 | 0.013 | 0.073 | |
| RG | 0.273 | 0.610 | 0.602 | 0.668 | 0.372 | 0.963 | 0.325 | 0.522 | 0.406 | 0.499 | 0.141 | 0.014 | 0.074 | |
| Single 划分 | ||||||||||||||
| Naive | Copy | 0.000 | 0.635 | 0.815 | 1.000 | 0.992 | 0.679 | 0.000 | 0.555 | 0.000 | 0.524 | 0.051 | 0.004 | 0.033 |
| Naive | Target | 0.365 | 1.000 | 0.019 | 0.111 | 0.091 | 0.133 | 0.445 | 1.000 | 0.476 | 1.000 | 1.000 | 1.000 | 1.000 |
| Llama3.2-3B-Instruct | Simple | 0.265 | 0.793 | 0.280 | 0.414 | 0.411 | 0.446 | 0.346 | 0.787 | 0.349 | 0.801 | 0.426 | 0.388 | 0.411 |
| STYLL | 0.315 | 0.618 | 0.239 | 0.450 | 0.209 | 0.956 | 0.394 | 0.503 | 0.426 | 0.538 | 0.119 | 0.026 | 0.075 | |
| RG-C | 0.263 | 0.611 | 0.514 | 0.618 | 0.334 | 0.951 | 0.406 | 0.457 | 0.429 | 0.516 | 0.070 | 0.005 | 0.045 | |
| RG | 0.252 | 0.612 | 0.530 | 0.654 | 0.390 | 0.923 | 0.324 | 0.524 | 0.329 | 0.529 | 0.077 | 0.008 | 0.048 | |
| Llama3.1-8B-Instruct | Simple | 0.244 | 0.759 | 0.404 | 0.534 | 0.505 | 0.496 | 0.361 | 0.804 | 0.315 | 0.770 | 0.327 | 0.287 | 0.311 |
| STYLL | 0.313 | 0.625 | 0.284 | 0.507 | 0.226 | 0.958 | 0.379 | 0.554 | 0.438 | 0.500 | 0.133 | 0.014 | 0.070 | |
| RG-C | 0.264 | 0.613 | 0.532 | 0.626 | 0.341 | 0.946 | 0.377 | 0.476 | 0.434 | 0.483 | 0.091 | 0.008 | 0.054 | |
| RG | 0.259 | 0.610 | 0.541 | 0.646 | 0.368 | 0.935 | 0.325 | 0.529 | 0.383 | 0.510 | 0.099 | 0.010 | 0.057 | |
| Diverse 划分 | ||||||||||||||
| Naive | Copy | 0.000 | 0.613 | 0.879 | 1.000 | 0.989 | 0.754 | 0.000 | 0.567 | 0.000 | 0.505 | 0.070 | 0.005 | 0.041 |
| Naive | Target | 0.387 | 1.000 | 0.010 | 0.086 | 0.113 | 0.067 | 0.433 | 1.000 | 0.495 | 1.000 | 1.000 | 1.000 | 1.000 |
| Llama3.2-3B-Instruct | Simple | 0.286 | 0.755 | 0.294 | 0.457 | 0.446 | 0.532 | 0.344 | 0.719 | 0.332 | 0.672 | 0.382 | 0.313 | 0.352 |
| STYLL | 0.340 | 0.597 | 0.189 | 0.490 | 0.221 | 0.978 | 0.380 | 0.532 | 0.421 | 0.517 | 0.148 | 0.015 | 0.076 | |
| RG-C | 0.286 | 0.594 | 0.478 | 0.631 | 0.336 | 0.960 | 0.378 | 0.495 | 0.400 | 0.531 | 0.108 | 0.009 | 0.061 | |
| RG | 0.285 | 0.598 | 0.493 | 0.649 | 0.364 | 0.952 | 0.339 | 0.533 | 0.348 | 0.540 | 0.113 | 0.011 | 0.062 | |
| Llama3.1-8B-Instruct | Simple | 0.275 | 0.753 | 0.367 | 0.520 | 0.509 | 0.524 | 0.339 | 0.740 | 0.298 | 0.678 | 0.380 | 0.320 | 0.354 |
| STYLL | 0.342 | 0.621 | 0.200 | 0.527 | 0.209 | 0.968 | 0.389 | 0.532 | 0.423 | 0.551 | 0.206 | 0.020 | 0.096 | |
| RG-C | 0.296 | 0.602 | 0.520 | 0.637 | 0.338 | 0.965 | 0.368 | 0.510 | 0.392 | 0.540 | 0.149 | 0.014 | 0.076 | |
| RG | 0.294 | 0.602 | 0.531 | 0.651 | 0.347 | 0.964 | 0.352 | 0.531 | 0.376 | 0.553 | 0.155 | 0.015 | 0.078 | |
E.2 正式度迁移(GYAFC)
表 7:不同改写系统在 GYAFC 任务上的评估结果(EM 与 FR 两域、I2F 与 F2I 两方向,Llama-3.2-3B-Instruct)。粗体为非朴素系统中的最优值。列含义:Acc(DeBERTa)、MIS、Sbert、Meteor、COLA、StyleCAV 的 Away/Towards、Biber 的 Away/Towards、Overlap Rouge-1/2/L(↓)。
| 设置 | 系统 | Acc DeBERTa | MIS | Sbert | Meteor | COLA | Away SC | Towards SC | Away Biber | Towards Biber | Ov.R-1↓ | Ov.R-2↓ | Ov.R-L↓ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| EM_I2F | Copy | 0.064 | 0.868 | 0.824 | 0.738 | 0.746 | 0.000 | 0.554 | 0.000 | 0.484 | 0.059 | 0.002 | 0.054 |
| EM_I2F | Target | 0.999 | 0.007 | 0.100 | 0.137 | 0.253 | 0.446 | 1.000 | 0.516 | 1.000 | 1.000 | 1.000 | 1.000 |
| EM_I2F | Gold | 0.921 | 0.877 | 0.876 | 0.999 | 0.925 | 0.439 | 0.633 | 0.267 | 0.598 | 0.071 | 0.004 | 0.065 |
| EM_I2F | Simple | 0.476 | 0.378 | 0.461 | 0.432 | 0.727 | 0.385 | 0.682 | 0.280 | 0.545 | 0.299 | 0.201 | 0.265 |
| EM_I2F | STYLL | 0.554 | 0.280 | 0.490 | 0.292 | 0.970 | 0.488 | 0.603 | 0.361 | 0.379 | 0.141 | 0.010 | 0.080 |
| EM_I2F | RG-C | 0.886 | 0.554 | 0.599 | 0.402 | 0.983 | 0.544 | 0.535 | 0.429 | 0.684 | 0.087 | 0.006 | 0.060 |
| EM_I2F | RG | 0.347 | 0.580 | 0.630 | 0.443 | 0.929 | 0.406 | 0.584 | 0.307 | 0.464 | 0.088 | 0.006 | 0.058 |
| EM_F2I | Copy | 0.024 | 0.802 | 0.738 | 0.595 | 0.933 | 0.000 | 0.338 | 0.000 | 0.522 | 0.056 | 0.001 | 0.053 |
| EM_F2I | Target | 0.887 | 0.005 | 0.110 | 0.128 | 0.000 | 0.662 | 1.000 | 0.478 | 1.000 | 1.000 | 1.000 | 1.000 |
| EM_F2I | Gold | 0.830 | 0.787 | 0.796 | 0.999 | 0.743 | 0.461 | 0.654 | 0.334 | 0.666 | 0.046 | 0.002 | 0.043 |
| EM_F2I | Simple | 0.869 | 0.359 | 0.436 | 0.330 | 0.517 | 0.534 | 0.749 | 0.388 | 0.819 | 0.310 | 0.236 | 0.286 |
| EM_F2I | STYLL | 0.533 | 0.279 | 0.473 | 0.301 | 0.951 | 0.366 | 0.378 | 0.452 | 0.602 | 0.127 | 0.009 | 0.072 |
| EM_F2I | RG-C | 0.482 | 0.535 | 0.584 | 0.398 | 0.944 | 0.326 | 0.379 | 0.357 | 0.563 | 0.089 | 0.006 | 0.057 |
| EM_F2I | RG | 0.707 | 0.538 | 0.598 | 0.424 | 0.939 | 0.319 | 0.387 | 0.358 | 0.612 | 0.090 | 0.007 | 0.057 |
| FR_I2F | Copy | 0.072 | 0.868 | 0.797 | 0.748 | 0.790 | 0.000 | 0.550 | 0.000 | 0.471 | 0.070 | 0.003 | 0.063 |
| FR_I2F | Target | 0.996 | 0.015 | 0.093 | 0.155 | 0.520 | 0.450 | 1.000 | 0.529 | 1.000 | 1.000 | 1.000 | 1.000 |
| FR_I2F | Gold | 0.937 | 0.877 | 0.848 | 1.000 | 0.944 | 0.437 | 0.620 | 0.249 | 0.628 | 0.081 | 0.005 | 0.072 |
| FR_I2F | Simple | 0.553 | 0.341 | 0.421 | 0.400 | 0.916 | 0.438 | 0.658 | 0.337 | 0.592 | 0.214 | 0.118 | 0.179 |
| FR_I2F | STYLL | 0.641 | 0.355 | 0.434 | 0.299 | 0.989 | 0.501 | 0.604 | 0.371 | 0.584 | 0.099 | 0.008 | 0.063 |
| FR_I2F | RG-C | 0.899 | 0.482 | 0.475 | 0.314 | 0.990 | 0.567 | 0.501 | 0.480 | 0.658 | 0.104 | 0.007 | 0.067 |
| FR_I2F | RG | 0.423 | 0.574 | 0.552 | 0.420 | 0.977 | 0.449 | 0.577 | 0.323 | 0.554 | 0.095 | 0.007 | 0.061 |
| FR_F2I | Copy | 0.046 | 0.793 | 0.683 | 0.590 | 0.921 | 0.000 | 0.360 | 0.000 | 0.492 | 0.055 | 0.004 | 0.042 |
| FR_F2I | Target | 0.845 | 0.010 | 0.094 | 0.144 | 0.042 | 0.640 | 1.000 | 0.508 | 1.000 | 1.000 | 1.000 | 1.000 |
| FR_F2I | Gold | 0.850 | 0.780 | 0.751 | 0.999 | 0.822 | 0.471 | 0.678 | 0.322 | 0.618 | 0.050 | 0.003 | 0.037 |
| FR_F2I | Simple | 0.820 | 0.325 | 0.394 | 0.312 | 0.745 | 0.464 | 0.666 | 0.457 | 0.657 | 0.213 | 0.127 | 0.182 |
| FR_F2I | STYLL | 0.500 | 0.337 | 0.406 | 0.294 | 0.987 | 0.297 | 0.335 | 0.374 | 0.657 | 0.090 | 0.007 | 0.057 |
| FR_F2I | RG-C | 0.396 | 0.499 | 0.487 | 0.352 | 0.986 | 0.316 | 0.332 | 0.347 | 0.532 | 0.094 | 0.007 | 0.060 |
| FR_F2I | RG | 0.647 | 0.550 | 0.515 | 0.404 | 0.972 | 0.305 | 0.365 | 0.336 | 0.656 | 0.086 | 0.007 | 0.056 |
E.3 Cochrane(文本简化)
表 8:不同改写系统在 Cochrane 数据集上的评估结果(Llama-3.2-3B-Instruct)。粗体为非朴素系统中的最优值。
| 系统 | FKGL↓ | ARI↓ | Rouge-1 | Rouge-2 | Rouge-L | BLEU | SARI | COLA | Away SC | Towards SC | Away Biber | Towards Biber | Ov.R-1↓ | Ov.R-2↓ | Ov.R-L↓ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Copy | 12.81 | 15.26 | 0.438 | 0.196 | 0.250 | 0.132 | 0.418 | 0.969 | 0.000 | 0.903 | 0.000 | 0.515 | 0.234 | 0.028 | 0.113 |
| Target | 11.68 | 13.86 | 0.253 | 0.031 | 0.125 | 0.005 | 0.346 | 0.965 | 0.097 | 1.000 | 0.485 | 1.000 | 1.000 | 1.000 | 1.000 |
| Gold | 11.49 | 13.66 | 1.000 | 1.000 | 1.000 | 1.000 | 0.982 | 0.967 | 0.071 | 0.907 | 0.393 | 0.610 | 0.253 | 0.031 | 0.125 |
| Simple | 11.76 | 13.95 | 0.281 | 0.054 | 0.143 | 0.022 | 0.353 | 0.967 | 0.086 | 0.974 | 0.425 | 0.921 | 0.864 | 0.832 | 0.851 |
| STYLL | 13.61 | 15.53 | 0.371 | 0.102 | 0.200 | 0.041 | 0.382 | 1.000 | 0.096 | 0.889 | 0.598 | 0.316 | 0.239 | 0.025 | 0.129 |
| RG-C | 11.47 | 13.58 | 0.399 | 0.126 | 0.207 | 0.068 | 0.390 | 1.000 | 0.120 | 0.860 | 0.551 | 0.487 | 0.251 | 0.028 | 0.125 |
| RG | 14.55 | 17.16 | 0.397 | 0.141 | 0.213 | 0.082 | 0.374 | 0.998 | 0.088 | 0.873 | 0.365 | 0.336 | 0.234 | 0.027 | 0.118 |
附录 F:定性示例
表 9:不同改写系统在目标风格示例条件下生成的示例输出(输入保持不变:"Verratti is practically untouchable. He's signing an extension every year or so and PSG won't sell for even a €100m.")。
| 目标示例(多篇拼接) | RG-Contrastive | RG | STYLL | Simple |
|---|---|---|---|---|
| “He didn't do any of that” / “Aaaaanndd you are all on a list.” / “Oh for fucks sake You are brilliant” / “>Hearing DADDDDYYYYY!!” …(另 13 例拼接) | oh man, verratti is basically untouchable, no way psg would sell him for anything less than a gazillion euros, and even then they'd probably just give him a massive extension to keep him happy, i mean, the guy's basically a god on the pitch | Dude, Verratti is basically untouchable - he's always signing a new deal and PSG would never even consider selling him for a hundred million euros, let alone that. | Verratti's not going anywhere, lol. He's always locking down new deals and PSG is like "nah, we're not selling him for more than a sweet, sweet €100m." | Verratti is practically untouchable, he's signing an extension every year or so & PSG won't sell for even a €100m. |
| “Log in you damned ones!” / “Loving the Japanese commentary team.” / “Jesus Christ, Cesaro!” / “Theatrics, dude.” …(另 12 例拼接) | Verratti is basically untouchable, like he's signing extension after extension every year or so and PSG is all "nope, not selling him for a single euro." | Verratti is basically untouchable – he's signing a new deal every year or so and PSG is like, "no way, he's staying." They wouldn't even sell him for a cool €100m. | Oh man, you think PSG is just gonna let Verratti walk out the door? Please, they're basically married to the guy. He's like the bread and butter of the team… He's basically a legend…(含多处新增细节) | Log in you damned ones! Verratti's like untouchable, dude. He's signing extensions left and right, PSG's gonna be stuck with him for ages. |
| “…the music and the coffee.” / “I'm humble as fuck.” / “Jesus, when did we start talking about French food?” …(另 13 例拼接) | Verratti is practically untouchable. He's signing an extension every year or so and PSG won't sell for even a €100m. I mean, come on… what even is the point of having a €100m clause if you're not gonna use it, lol? | Verratti is basically untouchable, he's always signing a new deal and PSG won't even consider selling him for a hundred million euros. | Verratti's like glue, man — nobody can get rid of him. He's always signing a new contract… if they do decide to sell him, they're only gonna get €100m, max. | Verratti's a total god, son. He's signing an extension every year or so and PSG ain't gonna let him go for even a €100m. |
| “Bioshock has been confirmed for a long time though…” …(另 15 例拼接) | so i think Verratti's basically unmoveable — always seems to be signing a new deal every year or so and PSG's like, "nah, we're not letting him go for less than €100m." | Dude, Verratti is basically untouchable — every year or so he's signing a new deal and PSG is all like "no way, we're not selling him for less than €100m." | "Come on, you think PSG is gonna just dump Verratti like a hot potato…? The guy's a genius on the field…"(含多处新增内容与反讽语气) | Verratti is basically unmovable, he's always signing some kind of extension and PSG isn't gonna let him go for even a €100m. |
| "This analogy doesn't really work for Jim, per se" / "And her lopsided breasts." …(另 13 例拼接) | It's a well-documented fact that Verratti has an ironclad contract… standing firm like a Gallic fortress at €100m. | OMG, you guys, Verratti is basically untouchable, lol. Every year he's signing a new deal and PSG is like 'no way, we're not selling him for even a cent'… | Oh boy, PSG is totally desperate to keep Verratti, and he's just thrilled to be stuck with them…(语气与原意出现偏移) | Verratti's practically untouchable, dude. He's signing an extension every year or so and PSG's gonna be like "no way, we're not selling him for even a €100m, he's our golden boy. |
说明:表中英文为模型原始输出(保留以反映真实风格特征);因篇幅所限,部分长输出做了省略(以"…"标注)。