模仿得到吗?还不能:LLM 仍难以模仿日常作者的隐性写作风格
摘要
随着大语言模型(LLM)日益融入个人写作工具,一个关键问题浮现:LLM 能否仅凭少量示例忠实模仿一个人的写作风格?个人风格往往细微而隐性,难以通过提示词显式指定,却对"与用户对齐的生成"至关重要。
本文对当前最先进 LLM 通过上下文学习、从少量用户手写样本中模仿个人写作风格的能力进行了全面评估。我们引入了一套互补指标组合——包括作者归属(AA)、作者验证(AV)、风格匹配与 AI 检测——以稳健地评估风格模仿。评估覆盖新闻、邮件、论坛、博客等领域,每个模型超过 40,000 次生成,涉及 400 余位真实作者。
结果显示:LLM 能在新闻、邮件等结构化文体中近似用户风格,但在博客、论坛等细微的非正式写作上力不从心;生成结果往往退回平均化的通用语气,且容易被识别为 AI 生成。对多种提示策略(如示例数量)的进一步分析揭示了有效个性化的关键局限。我们的发现凸显了 LLM 个性化适配的根本性差距,以及改进隐性、风格一致生成技术的必要性。为促进后续研究与可复现性,我们开源了数据与代码。
1 引言
人每次写作都会留下独特的语言指纹(Svartvik, 1968)——这是对个人风格微妙而潜意识的反映。为提升写作,人们早已使用从拼写/语法检查器到复述工具的各种写作辅助(Ferris, 2004)。而大语言模型(LLM)的兴起带来了强大的"一站式"助手,能够起草、编辑与改写文本(Wasi et al., 2024)。尽管 LLM 的流畅度令人印象深刻,它们却常常默认使用从海量网络数据中学到的通用风格,抹去了让写作显得真实的个人印记(Padmakumar & He, 2024)。这引发了"作者身份稀释"与被标记为 AI 生成内容的担忧(Tripto et al., 2024)。
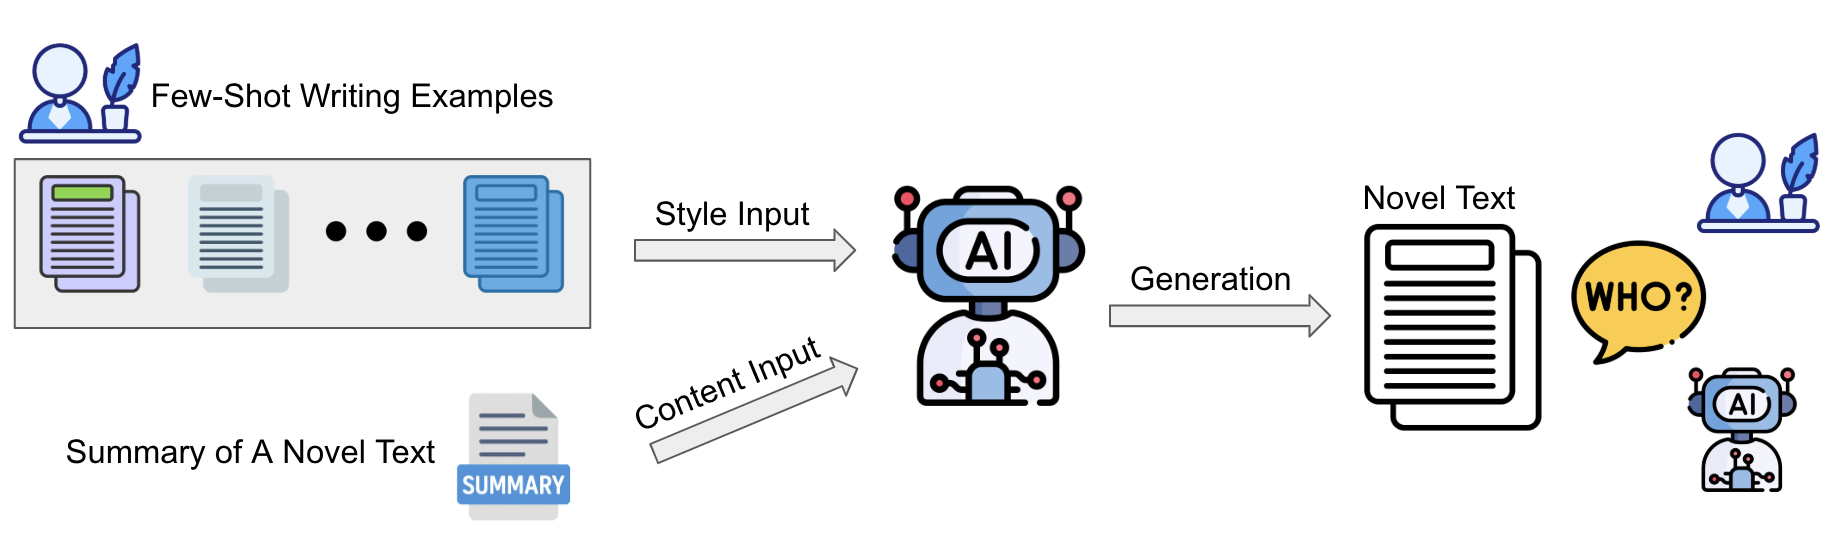
为应对这些担忧,一些系统(如 Claude AI)提供语气、声音、正式度等可配置参数。然而这些控制手段收效有限——用户的个人风格细微精妙,很难被几个滑块概括(Kang & Hovy, 2021)。更自然的方案是用个人既往写作的示例来引导模型,即以少样本提示更忠实地模仿个人风格(如图 1 所示的任务)。LLM 已展现出模仿公众人物(Herbold et al., 2024; Chen & Moscholios, 2024)与虚构角色(Li et al., 2023)的潜力——这些对象在互联网上数据足迹丰富、易于建模——但它们复现日常用户风格的能力仍基本未被探索。
仅凭少量日常交互、没有任何显式风格定义,LLM 真能适应一位日常作者的风格吗?
面向普通用户的个人风格生成研究有限(Bhandarkar et al., 2024; Cho et al., 2025),更迫切的问题是缺乏稳健的评估:我们如何判断 LLM 生成文本在风格与声音上是否属于同一个人?作者身份概念本质上主观,但司法语言学中成熟的作者归属(AA)与作者验证(AV)等计算方法提供了有前景的代理指标。"语言个体性理论"(Nini, 2023)认为,一个人的写作风格往往构成一致的"风格模型"。若 LLM 生成的文本既能落入该风格模型、又能被两套计算作者模型判定为同一作者,我们就离真正个性化的文本生成更近了一步。
本文考察 LLM 能否在无显式风格指令的条件下,通过上下文学习模仿日常用户的隐性写作风格(任务见图 1)。我们的研究植根于一个现实场景:大多数用户通过标准界面而非定制插件或微调管线与 LLM 交互(Wang et al., 2024)。尽管个性化微调(Liu et al., 2024)或高级提示策略(Cho et al., 2025)能改善风格对齐,但在时间敏感的真实场景中往往不切实际。因此我们聚焦评估当前 LLM 的"开箱即用"能力:以少量用户书写样本为条件复现个人写作风格——这正是实践中最易获得、最具可扩展性的隐性个性化形态。
为此,我们对最先进 LLM 在个性化写作模仿任务上的表现做了全面评估。该任务定义为:仅从既往写作样本出发、无显式风格指令、以内容摘要进行语义约束地模仿个体隐性写作风格(见图 1)。鉴于个人风格难以度量,我们采用多角度计算评估器:作者归属、作者验证、语言学根基的风格指标,以及最先进的 AI 检测工具。这一组合可对"风格忠实度"与"类人生成"进行稳健而多面的评估。
基于该框架,我们评估了来自 OpenAI、Google、Meta、DeepSeek 的前沿模型,覆盖新闻、邮件、论坛、博客等具有不同风格约束的写作领域。数据集涉及 400 余位作者,并基于既有工作构建以确保多样性与真实性。我们考察:少量既往写作的少样本演示,是否足以让 LLM 生成匹配作者声音与风格的输出。
结果显示:LLM 在新闻、邮件等较结构化文体中能部分模仿用户风格,但在博客、论坛等细微非正式表达上表现挣扎;输出常退回平均化、通用化的语气,且容易被识别为 AI 写作。此外,增加演示数量对风格对齐的增益有限。这些发现凸显了上下文个性化当前的局限,并指出需要更有效的方法来实现真正个性化的生成——这是 LLM 写作工具民主化的关键一步。
2 相关工作
LLM 个性化涵盖从人格模拟(Tseng et al., 2024)到个性化内容推荐(Lyu et al., 2024)的广阔谱系。本文则聚焦于更微妙的隐性个性化写作模仿挑战:LLM 能否生成体现"从个体既往写作中学到的隐性风格"的文本。为此,我们梳理"基于 LLM 的个性化写作"与"围绕 LLM 生成文本的作者分析"两个方向的进展。
面向个性化写作的 LLM。LLM 的进展已在通用文本风格迁移上取得出色表现(Toshevska & Gievska, 2025),个性化文本生成也日益受到关注(Zhang et al., 2024)。既往工作多聚焦于复现知名人物的风格:作家(Mikros, 2025; Dinu et al., 2025)、名人(Herbold et al., 2024; Chen & Moscholios, 2024)或虚构角色(Li et al., 2023; Park et al., 2025)——这些对象拥有充足训练数据与丰富背景设定。然而,复现普通人风格的研究仍很欠缺,尤其是严格、系统的评估。
近期一些研究尝试用检索增强生成(RAG)系统(Mysore et al., 2024)或"试错-解释"(Trial-Error-Explain)等高级上下文提示策略(Cho et al., 2025)实现个体化生成,但这些方法往往成本高、难以实时化,或依赖多轮 LLM 查询。关键是,这类研究通常依赖 LLM-as-a-judge(Zheng et al., 2023)度量风格对齐;虽然 LLM 在作者分析任务上表现不凡(Huang et al., 2024),其判断仍主观,且可能对自己生成的内容存在偏好偏差(Panickssery et al., 2024)。
另一些评估使用 ROUGE、METEOR 等指标(Kumar et al., 2024)——它们衡量内容重叠,却忽略风格忠实度。作者归属(AA)也曾被使用(Bhandarkar et al., 2024),但通常限于狭窄领域或单文本续写,缺乏更全面的风格考量。因此,我们提出一个植根于作者分析与文体计量学的综合评估框架,系统考察 LLM 能否真正复现个人写作风格。
作者分析任务。为评估 LLM 能否真正复现个体风格,我们借鉴成熟的作者分析任务:作者归属(AA)从候选作者集合中识别文本作者(Kjell et al., 1994);作者验证(AV)判断两段文本是否同一作者(Halteren, 2007)。这些任务传统上依赖 n-gram 与文体计量线索,如词汇、句法、语义与结构模式(Stamatatos, 2009; Koppel et al., 2012; Juola & Stamatatos, 2013; Neal et al., 2017)。经典机器学习与深度模型长期用于文体计量,而微调后的 Transformer 模型目前代表了 AA/AV 的最先进水平(Tyo et al., 2022; Tripto et al., 2023)。近来,文体计量分析也被用于检测 LLM 生成文本(Herbold et al., 2023; Muñoz-Ortiz et al., 2024; Casal & Kessler, 2023),为评估 LLM 输出是否贴合目标个人风格提供了有前景的路径。
3 方法
本研究评估 LLM 能否在无任何显式风格指令的情况下,仅凭少量既往示例模仿用户的隐性写作风格。我们考虑如图 1 所示的现实场景:用户提供少量写作样本与一份内容摘要——即典型少样本提示——而不详细描述自己的风格(即便可行,这也颇有难度)。该设定无需模型定制,提供了一条可扩展的个性化路径。写作风格会随时间演变(文体计时学 stylochronometry 研究此现象,Can & Patton, 2004),但那主要关注小说家或公众人物的长期变化(Stamou, 2007; Klaussner & Vogel, 2015);在我们的语境中,假设个体在日常写作中保持相对稳定的风格——这一假设既实用也合理。
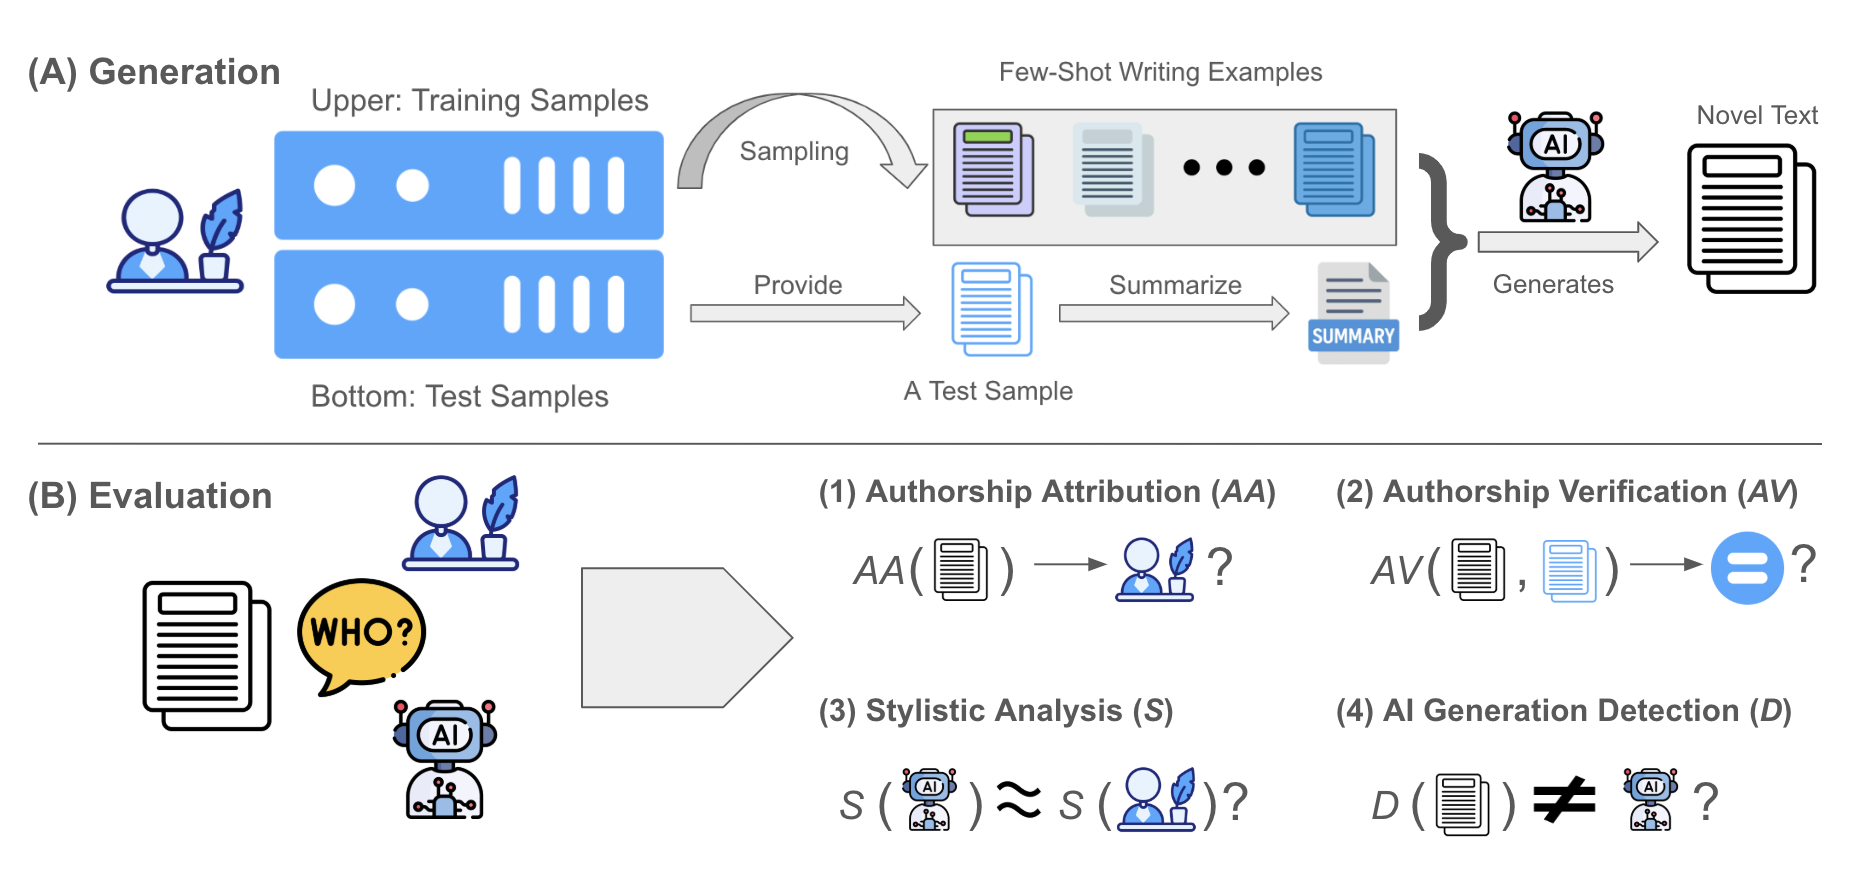
图 2 给出了方法论的总体图示。下文结构:3.1 任务设定、3.2 评估框架、3.3 数据集、3.4 设计选择与局限讨论。
3.1 任务设定与符号
我们形式化"隐性个性化写作模仿"任务。给定人类作者 \(a \in A\)(\(A\) 为全体作者集合),记 \(T_a\) 为作者 \(a\) 的全部写作样本集合。把 \(T_a\) 划分为训练集 \(T_a^{tr}\)(用于抽取少样本写作示例)与测试集 \(T_a^{te}\)(用于评估)。对任一测试样本 \(t_a \in T_a^{te}\),用 \(n\) 个写作样本 \(T_a^{tr'} \subseteq T_a^{tr}\) 和 \(t_a\) 的内容摘要 \(S_{t_a}\) 提示 LLM \(L\),生成新文本 \(t_a^L\),即形式化地 \(L(T_a^{tr'}, S_{t_a}) \to t_a^L\)(见图 2(A))。这里摘要 \(S_{t_a}\) 用于固定生成文本的内容(语义),从而使我们能在语义受控条件下专注评估 \(t_a^L\) 与作者写作风格的对齐程度。
评估时同时考察两方面:生成文本 \(t_a^L\) 对作者 \(a\) 整体写作风格的忠实度,以及 \(t_a^L\) 与具体测试样本 \(t_a\) 在固有风格上的接近程度。
3.2 个性化写作评估框架
为衡量 LLM 复现隐性个人风格的程度,我们提出一个植根于计算作者分析与"类人度检测"的多角度评估框架(见图 2(B)),包含四个组件:
- 作者归属模型 \(\mathrm{AA}(t) \to a\):预测给定文本 \(t\) 最可能的作者 \(a \in A\)。在人类写作文本(作者训练样本 \(T_a^{tr}\))上训练,用于检验生成文本能否被正确归属到目标作者。
- 作者验证模型 \(\mathrm{AV}(t, t') \to \{0,1\}\):若判定文本 \(t\) 与 \(t'\) 出自同一作者返回 1,否则 0。用于把每次生成与对应的人类参考文本比较。
- 风格模型 \(X_a\):为每位作者 \(a\) 构建,基于其写作样本 \(T_a\) 的分布与风格特征。随后计算生成文本 \(t\) 与各作者风格模型的距离,评估风格接近度。与通过微调隐式捕捉风格模式的 AA/AV 模型不同,该方式为"生成文本是否模仿了个体风格"提供了显式判据。
- AI 生成检测器 \(D(t)\):判别文本 \(t\) 更像人类写作还是 AI 生成。我们使用 GPTZero(因其在 AI 文本检测上的强力表现)。它从"类人度"维度补充前三者,提供超越风格忠实度的额外视角。
这些指标共同使我们能够以计算方式探查 LLM 生成文本是否与目标作者保持风格一致,从而可靠地评估个性化生成。
3.3 数据领域
我们使用表 1 所列四个数据集的子集:Enron(Klimt & Yang, 2004)、Blog(Schler et al., 2006)、CCAT50(Liu, 2011)、Reddit(Völske et al., 2017)。四个数据集代表四种迥异的文体(邮件、博客、新闻、论坛),合计约 400 位作者。格式上,邮件与新闻较结构化、正式,博客与论坛则更随意、非正式。这些特性为在真实场景中评估 LLM 的跨文体风格模仿能力提供了全面试验台。
我们对原始数据集做严格的长度控制采样,并把选中样本均匀划分为训练/测试集(详见附录 A)。除长度控制外采样完全随机,以在大规模采样下保证代表性。
3.4 任务设计的合理性讨论
微调常被视为实现个性化生成的可靠方法(Tan et al., 2024; Zhang et al., 2024),但我们有意回避:其一,真实用户通常只能提供少量写作样本,不足以有效微调;其二,为每位用户维护独立的微调模型成本高昂、难以规模化(Han et al., 2024)。此外,需要多轮 LLM 往返交互的复杂提示技术(如 Cho et al., 2025; Bhandarkar et al., 2024)会引入显著延迟与 API 开销,不适合实时使用(Shekhar et al., 2024)。
因此我们采用更贴近用户实际交互方式的做法:仅用界面中留存的历史写作样本做少样本提示(只需一次 API 调用),并以零样本场景作为基线对照。如前所述,本文的首要目标是严格评估"在最小引导下 LLM 模仿个人风格的能力"。主要实验采用随机采样示例;后续分析中我们还探索了基于主题相似度或长度相似度的采样等策略能否进一步提升风格相似度。
4 实验设置
本节概述实验的关键选择,更多细节见附录 B。
LLM 与提示。我们兼顾闭源与开源模型:GPT-4o、GPT-4o-mini(OpenAI et al., 2024)、Gemini-2.0-Flash(Google DeepMind, 2024)、Gemma-3-27B(Team et al., 2025)、DeepSeek-V3(DeepSeek-AI et al., 2025)、Llama-4-Maverick(Meta, 2025)。后两者为专家混合(MoE)模型:DeepSeek-V3 总参数 671B、每 token 激活 37B;Llama-4-Maverick 总参数 400B、激活 17B。所有提示温度固定为 0,以最大化输出的可复现性。
写作示例采样。对每个测试样本,提供 5 个从该作者训练集随机抽取的写作示例供风格模仿,所有 LLM 共用同一批示例。采用随机采样是因为原则上我们无法控制用户会用什么示例做提示——这保证了评估更贴近现实。
测试样本摘要。用 GPT-4.1(OpenAI, 2025)为每个测试样本生成摘要。
基线。以同样的测试样本做零样本提示(仅给内容摘要)作为基线。我们在实验中预期并验证:不提供示例时风格模仿更差。该简单基线有两个作用:(1)实证检验上述预期;(2)对本研究提出的评估框架做合理性检查。作为概念验证,零样本仅跑四个模型(不含 DeepSeek 与 Llama)。
评估模型。AA 与 AV 模型基于 Transformer 编码器训练,具体为 Longformer-base-4096 与 ModernBERT-base(细节见附录 B)。对每位作者,还基于 LIWC(Boyd et al., 2022)与 WritePrint(Abbasi & Chen, 2008)特征集,从其写作样本中抽取分布性风格特征,构建个体风格模型。这三类模型用于评估人类写作与 LLM 生成文本的风格忠实度。此外,直接使用开箱的 GPTZero 作为 AI 检测工具。
在人类文本上验证评估框架。为验证框架可靠性,先在原始人类写作文本上报告评估结果(表 1)——这反映理想条件(四个评估器只处理人类数据),可据此考察其性能上界。
表 1:研究中使用的四个测试集及其原始数据来源。对应的训练集具有相同的作者数/样本数及相近平均长度。"AV Acc."与"AA Top-5 Acc."为在相应训练集上训练的 AV/AA 模型的平均测试准确率;"% Style Acc."为作者测试样本距该作者本人的风格模型比距其他作者风格模型更近的比例;"% Human"为测试样本被检测为人类生成的比例。
| 数据集 | 文体 | #作者 | #样本 | 平均长度 | AV Acc.(%) | AA Top-5(%) | Style Acc.(%) | % Human |
|---|---|---|---|---|---|---|---|---|
| Enron | 邮件 | 150 | 3,884 | 309 | 88.9 | 79.8 | 79.4 | 99.2 |
| Blog | 博客 | 100 | 25,224 | 319 | 91.4 | 95.5 | 81.9 | 99.5 |
| CCAT50 | 新闻 | 50 | 2,500 | 584 | 89.2 | 94.9 | 69.1 | 100 |
| 在线论坛 | 100 | 8,451 | 333 | 87.7 | 89.7 | 73.8 | 100 |
在四个数据集上(Enron、Blog、CCAT50、Reddit),AV 模型准确率高达 87.7%–91.4%,AA 模型 Top-5 准确率为 79.8%–95.5%,说明两个模型微调良好、足以可靠评估作者一致性。此外,在相同特征表示上训练的 XGBoost 分类器取得了可观的 Top-1 作者归属准确率:CCAT50 46.16%、Enron 43.12%、Reddit 36.04%、Blog 34.11%——尽管候选作者数高达 50–150 位。这体现了我们文体计量框架捕捉个人写作风格的实力。风格模型也呈现一致的匹配(69.1%–81.9%,即作者的测试样本更贴近本人风格模型的频率)。最后,人类书写的测试样本几乎不会被 GPTZero 判为 AI 生成。综上,人类文本呈现出可区分、可个性化的风格模式,验证了评估框架的有效性。
5 结果
我们在评估框架下全面分析 LLM 模仿个性化风格的效果,并报告与原文的语义相似度,以确认生成输出在遵循给定内容的同时保留了示例中的风格线索。
5.1 作者归属准确率
表 2 报告了 5-shot(默认)与 0-shot(基线)设置下各数据集、各模型的平均 Top-5 AA 准确率。总体上,少样本提示一致优于零样本——提供既往样本确实帮助 LLM 生成与目标作者更风格对齐的文本。有趣的是,即使零样本也能取得非平凡的 Top-5 AA 准确率,主要归因于个人写作的主题/内容重叠。由于作者身份同时依赖内容与风格(Sari et al., 2018),我们的 AA 模型利用了这两个维度——这解释了无示例时的"高于随机"表现。这也凸显了需要其他评估(如本研究提供的)来对个性化写作做整体判断。
表 2:各 LLM 在少样本(5-shot)与零样本提示下的平均 Top-5 AA 准确率(越高越好)。对每个生成文本 \(t'\) 及其参考文本 \(t\),若真实作者 \(a\) 出现在 AA 模型 Top-5 预测中记 1 分;分数在两个 AA 模型上取平均。
| 模型 | 设置 | CCAT50 | Enron | Blog | |
|---|---|---|---|---|---|
| GPT-4o | 5-shot | 86.64 | 59.65 | 27.12 | 39.39 |
| 0-shot | 83.88 | 28.62 | 18.77 | 17.22 | |
| GPT-4o-mini | 5-shot | 87.36 | 56.45 | 26.30 | 38.47 |
| 0-shot | 85.84 | 27.56 | 18.95 | 16.10 | |
| Gemini-2.0-Flash | 5-shot | 92.17 | 59.56 | 35.59 | 44.34 |
| 0-shot | 87.72 | 28.93 | 19.14 | 19.62 | |
| Gemma-3-27B | 5-shot | 93.30 | 62.38 | 30.53 | 39.38 |
| 0-shot | 86.26 | 27.12 | 19.20 | 18.89 |
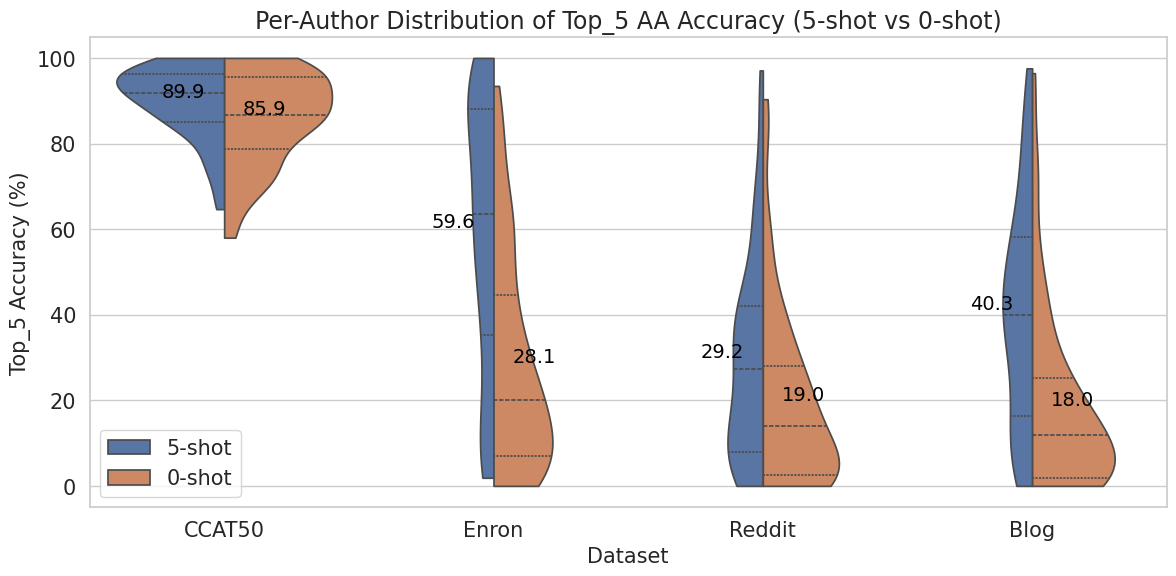
准确率在不同用户间也有差异(见图 3)。CCAT50 持续高准确率(可能因记者各覆盖独特主题),其他数据集波动更大。对所有作者,少样本一致优于零样本。值得注意的是,Gemini-2.0-Flash 与 Gemma-3-27B 在非正式领域(Reddit、博客)相对出色——这些领域包含 *、#、! 等因作者而异的风格线索。总体而言,这些发现凸显了个性化风格复现对数据集与模型的双重敏感性。
5.2 作者验证准确率
表 3:各 LLM 在 5-shot 与 0-shot 下(两个 AV 模型平均)的 AV 准确率。这里假设 LLM 生成样本与对应测试样本同属一位作者,因此准确率越高越好。
| 数据集 | 设置 | GPT-4o | GPT-4o-mini | Gemini-2.0-Flash | Gemma-3-27B | DeepSeek-V3 | Llama-4-Maverick |
|---|---|---|---|---|---|---|---|
| CCAT50 | 5-shot | 95.28 | 95.16 | 97.44 | 97.34 | 97.46 | 94.68 |
| 0-shot | 93.14 | 93.38 | 93.94 | 94.18 | - | - | |
| Enron | 5-shot | 96.15 | 96.64 | 96.44 | 96.17 | 96.30 | 95.65 |
| 0-shot | 85.02 | 85.68 | 85.95 | 84.98 | - | - | |
| 5-shot | 63.65 | 60.23 | 65.88 | 55.54 | 49.97 | 65.10 | |
| 0-shot | 56.66 | 54.28 | 53.25 | 48.75 | - | - | |
| Blog | 5-shot | 19.37 | 17.93 | 21.25 | 16.72 | 20.77 | 17.61 |
| 0-shot | 8.15 | 8.22 | 10.35 | 9.55 | - | - |
表 3 给出四个数据集上 LLM 生成文本的(Top-1)AV 准确率。跨所有模型与数据集,5-shot 一致优于 0-shot——仅提供少量写作示例就能显著提升 LLM 模仿隐性个人风格的能力。与 AA 结果类似,AV 性能也随数据集变化:在更结构化、正式的 CCAT50 与 Enron 上表现尤佳;在更非正式、风格多样的 Reddit 与 Blog 上普遍较低。尽管 Gemini-2.0-Flash、Gemma-3-27B、DeepSeek-V3 等多数 LLM 表现相近,其风格模仿效果仍高度依赖提示设计与数据集的风格特性——凸显了基于 LLM 的作者模仿对任务设定与领域特征的敏感性。
5.3 风格建模与对齐
我们采用 LIWC(Boyd et al., 2022,融合语言学与心理学线索)与 WritePrints(Abbasi & Chen, 2008,句法-词汇模式)特征集构建个体风格模型。为评估风格对齐,计算每个测试文本(无论人类或 LLM 生成)与对应作者风格模型之间的马氏距离(Mahalanobis distance)(McLachlan, 1999)。
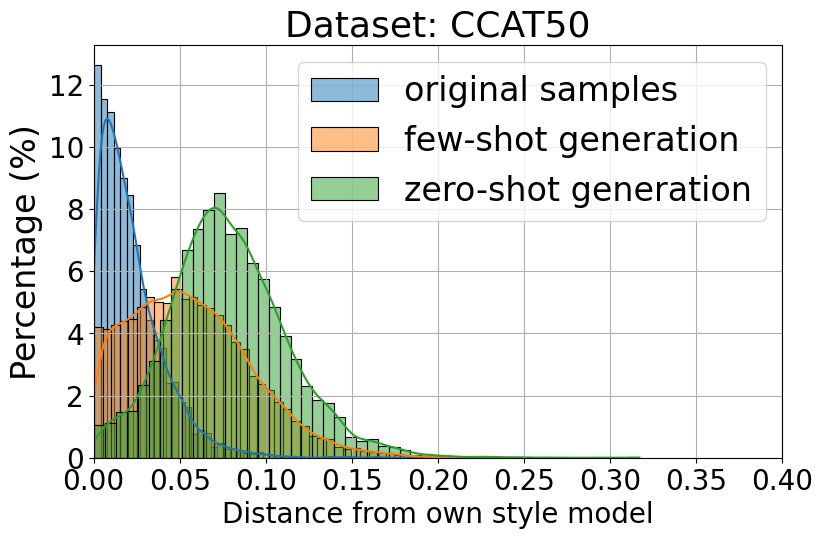
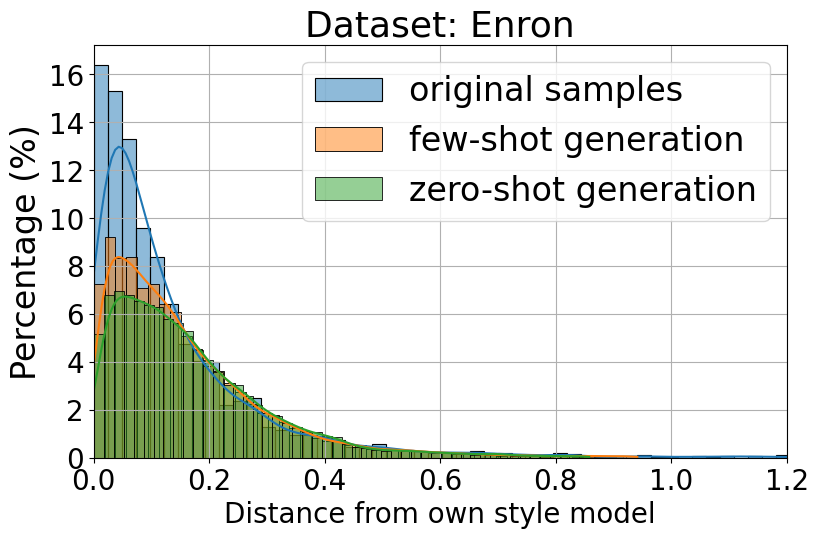
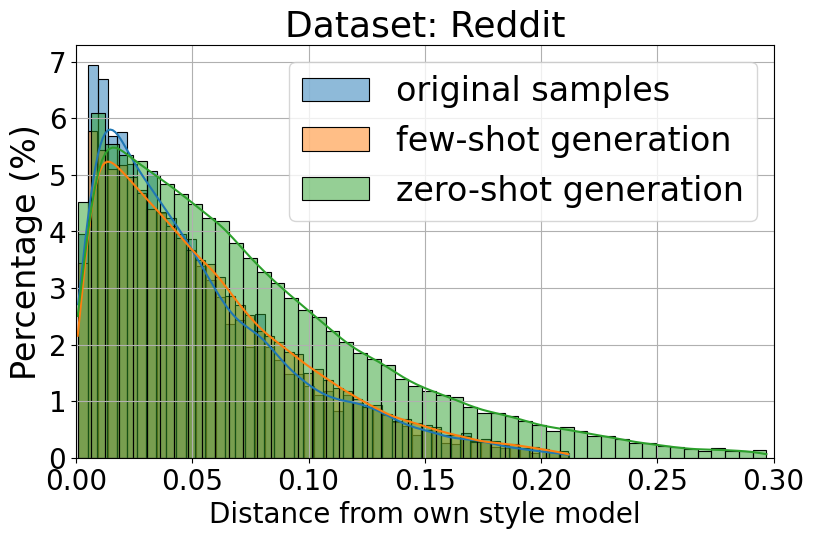
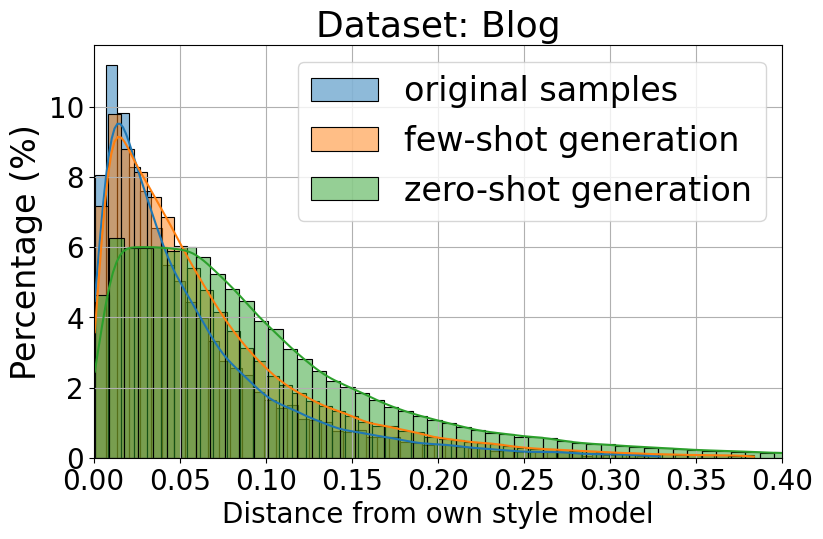
图 4 展示了 5-shot 与 0-shot 下每位作者全部测试样本的平均距离分布。符合预期,人类原始样本距离最低。关键在于:少样本生成显著比零样本更接近目标风格(经 Wilcoxon 符号秩检验确认,Conover, 1999)。这与我们的假设一致——没有示例提示时,LLM 退回通用风格。跨数据集的差异也与 AA/AV 的趋势一致。
5.4 AI 生成检测
表 4:被检测为人类文本的 LLM 生成文本占比(越高越好)。
| 模型 | 设置 | CCAT50 | Enron | Blog | |
|---|---|---|---|---|---|
| GPT-4o | 5-shot | 0.08 | 16.86 | 0.67 | 0.47 |
| 0-shot | 0.16 | 0.10 | 0.27 | 0.07 | |
| GPT-4o-mini | 5-shot | 0.00 | 13.76 | 0.12 | 0.35 |
| 0-shot | 0.08 | 0.08 | 0.19 | 0.12 | |
| Gemini-2.0-Flash | 5-shot | 20.49 | 54.25 | 20.77 | 18.74 |
| 0-shot | 0.44 | 1.88 | 1.18 | 0.79 | |
| Gemma-3-27B | 5-shot | 31.36 | 43.63 | 16.09 | 7.58 |
| 0-shot | 0.20 | 2.65 | 4.80 | 1.67 |
表 4 报告被 GPTZero 判为人类的比例,可视为"感知自然度与风格真实性"的代理。总体上 LLM 生成文本被判为人类的比例偏低(几乎所有模型与设置都低于 55%,常低于 20%)。这意味着:尽管 LLM 能在不同程度上骗过专门的 AA/AV 模型,成功"以假乱真"仍是艰巨挑战。有趣的是 GPT-4o/GPT-4o-mini 的检出率近乎为零;而 Gemini-2.0-Flash 与 Gemma-3-27B 明显更高(尤其在 Enron、CCAT50 等结构化数据上)——我们推测 GPTZero 可能针对 GPT 系模型的输出做了优化。因此检出率差异应谨慎解读:可能反映检测器偏差而非真实风格相似度。与前文一致,零样本在多数模型/数据集上的人类检出率更低。此外,提示设计、模型架构与目标领域特性都可能影响检出率。
5.5 语义相似度
实验中我们在提示里提供内容摘要以引导语义,从而在评估中聚焦写作风格。作为合理性检查,我们测量 LLM 生成文本与对应人类文本的语义相似度,以确认 LLM 确实按指令输出语义合规的生成。表 5 给出 METEOR、ROUGE(Kumar et al., 2024)与 SBERT(Reimers & Gurevych, 2019)分数。
表 5:LLM 生成文本与人类参考文本的平均内容相似度。
| 模型 | 设置 | METEOR | ROUGE-L | SBERT |
|---|---|---|---|---|
| GPT-4o | 5-shot | 0.32 | 0.24 | 0.77 |
| 0-shot | 0.30 | 0.21 | 0.76 | |
| GPT-4o-mini | 5-shot | 0.31 | 0.23 | 0.77 |
| 0-shot | 0.29 | 0.20 | 0.76 | |
| Gemini-2.0-Flash | 5-shot | 0.32 | 0.26 | 0.78 |
| 0-shot | 0.31 | 0.21 | 0.75 | |
| Gemma-3-27B | 5-shot | 0.30 | 0.23 | 0.75 |
| 0-shot | 0.29 | 0.19 | 0.74 |
分数表明 LLM 生成文本与人类写作语义相似(SBERT ≥ 0.74),说明其指令遵循能力很强。此外,5-shot 在三个指标上一致略高,与前文观察到的风格忠实度提升一致。我们猜测:更高的风格忠实度(体现在用词与措辞等元素上)可能有助于提升语义相似度。
6 后续研究(提示策略变量消融)
日常用户或许不止于随机示例 + 内容摘要。我们假设精心挑选的样本能更好地促进上下文学习(Kapuriya et al., 2025)。由于作者身份同时依赖内容与随文本长度变化的风格因素(Tripto et al., 2025),我们分别按内容相似度与长度相近性选择示例;此外还提供原文开头片段引导生成(Bhandarkar et al., 2024),并改变示例数量。为考察这些效应,我们在测试集的精选子集上使用 GPT-4o、Gemini-2.0-Flash、LLaMA-4-Maverick 评估,兼顾成本效率与同条件比较。
6.1 考察的条件
- 内容相似(+Sim ctrl):用 BERTopic(Grootendorst, 2022)对每位作者的写作(训练+测试样本)聚类;对每个测试样本,选取与其同簇的 5 个训练样本。该做法与基于语义相似度的 RAG 式示例选择(Mysore et al., 2024)类似。
- 长度对齐(+Len ctrl):对每个测试样本,选取长度最接近的 5 个训练样本。
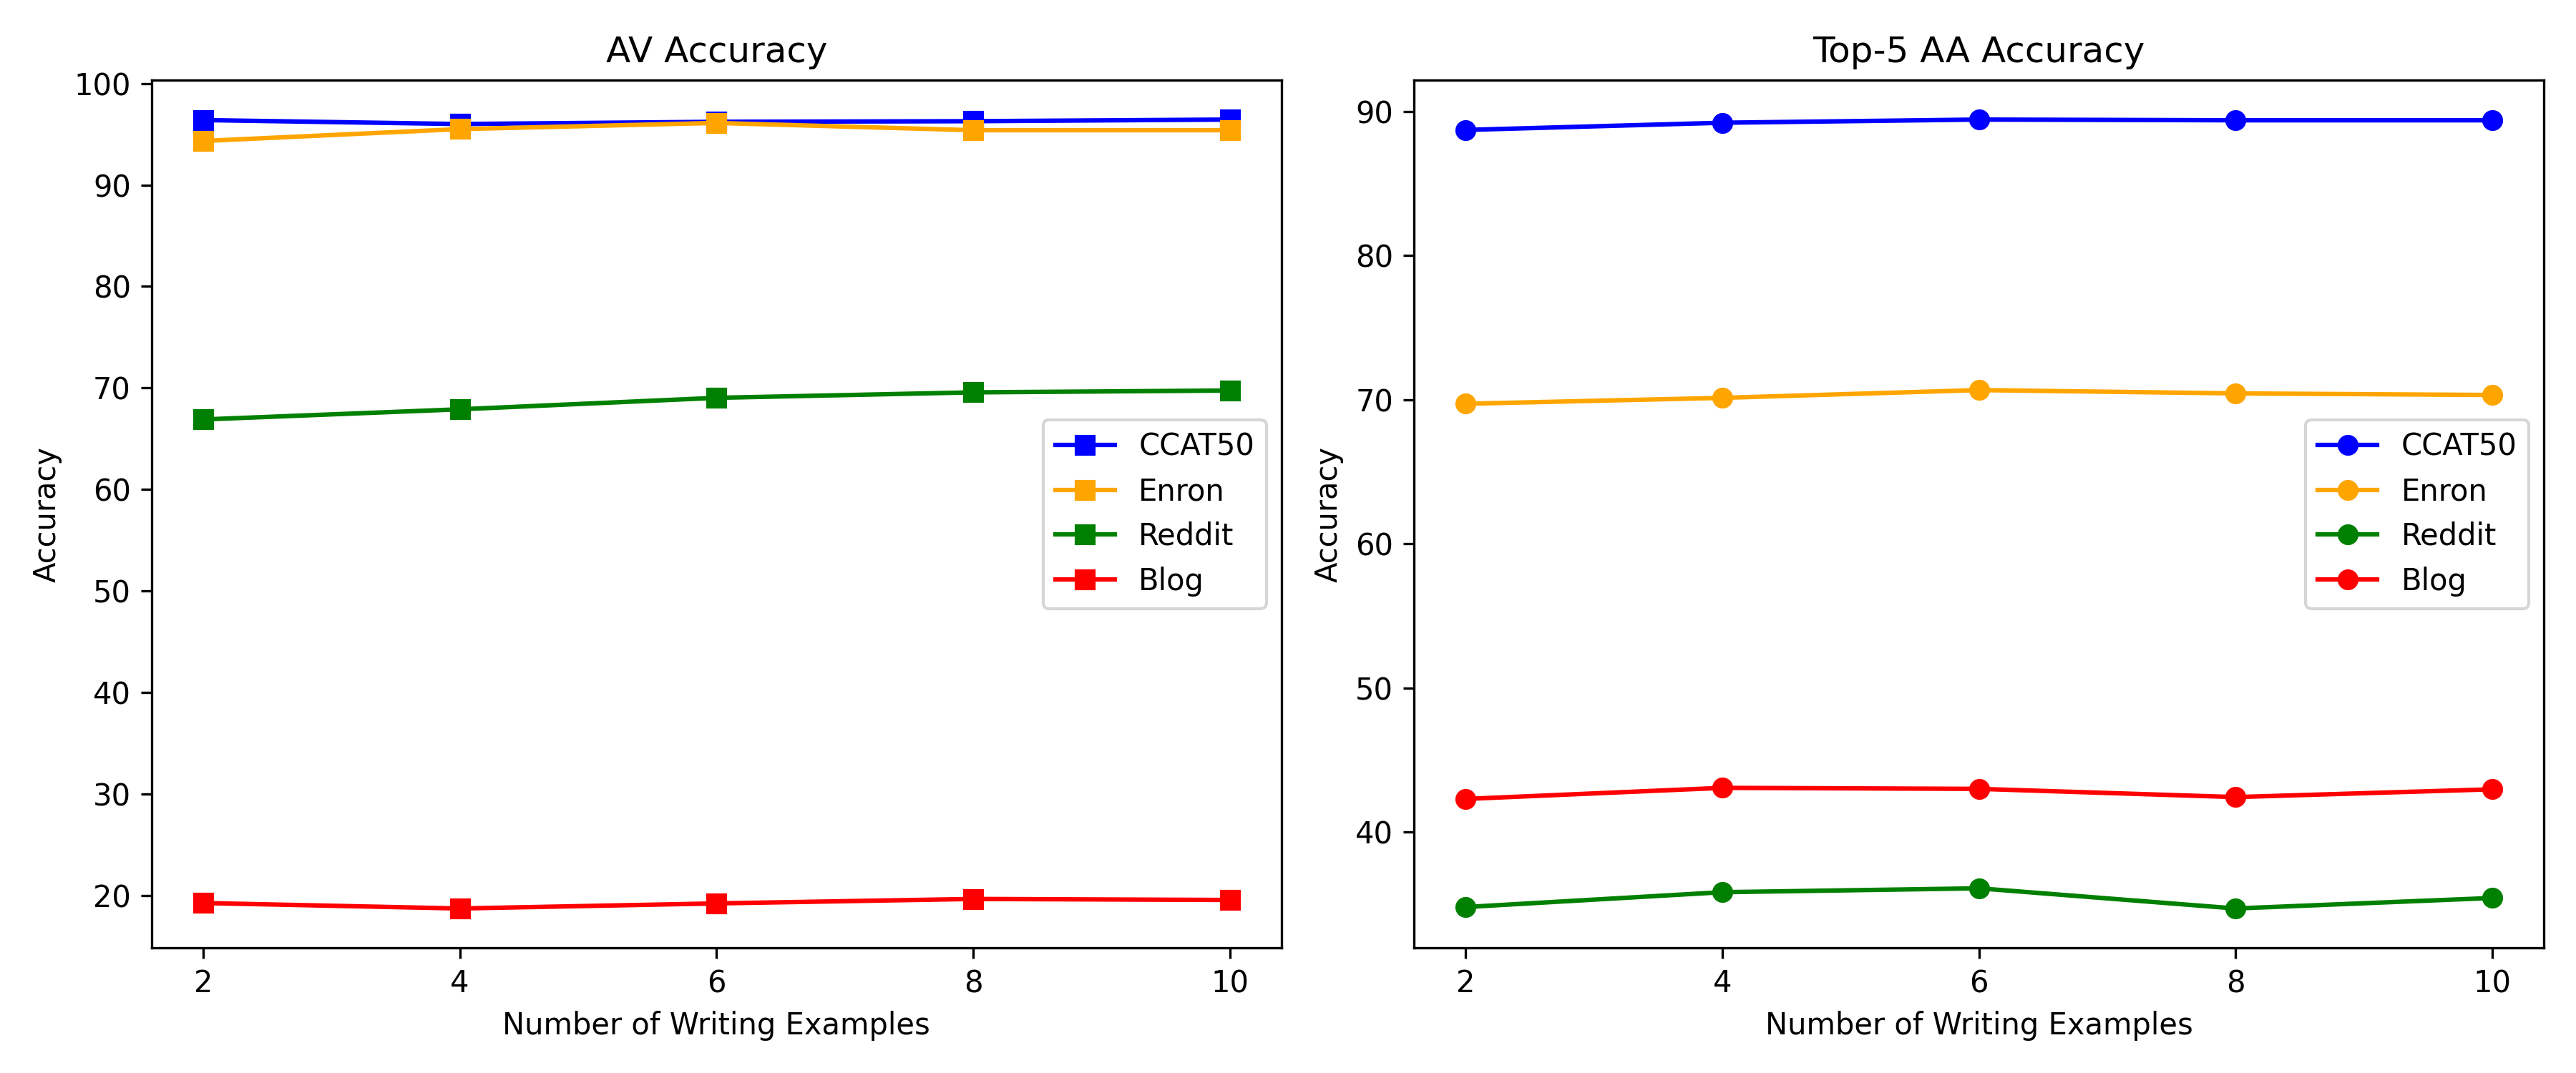
- 示例数量:分别取 2、4、6、8、10 个写作示例。为保证可比性,较小集合是较大集合的严格子集。
- 片段引导(+Snippet):沿用 Bhandarkar et al. (2024),在默认 5-shot 之外,把目标测试样本的开头片段(前 50 词或全文的 20%,取较短者)加入提示。
表 6:基于与第 6 节相同测试子集的后续结果(三个 LLM 平均)。+Snippet(†)仅对 LLM 续写部分评估,不含最初提供的作者片段。
| 数据集 | 设置 | AV | AA(Top-5) | Style Acc. | % Human |
|---|---|---|---|---|---|
| CCAT50 | 5-shot | 96.39 | 89.72 | 60.11 | 8.50 |
| + Len ctrl | 96.83 | 90.16 | 57.89 | 5.67 | |
| + Sim ctrl | 91.95 | 81.05 | 61.00 | 10.33 | |
| + Snippet † | 95.45 | 87.72 | 64.44 | 15.50 | |
| Enron | 5-shot | 95.44 | 69.33 | 72.11 | 36.83 |
| + Len ctrl | 95.89 | 71.44 | 61.22 | 23.67 | |
| + Sim ctrl | 81.28 | 36.00 | 70.00 | 39.67 | |
| + Snippet † | 90.56 | 60.50 | 68.44 | 46.50 | |
| 5-shot | 68.07 | 35.43 | 71.80 | 10.90 | |
| + Len ctrl | 70.07 | 35.60 | 56.60 | 51.50 | |
| + Sim ctrl | 53.10 | 16.63 | 69.33 | 12.60 | |
| + Snippet † | 72.83 | 36.83 | 68.27 | 22.10 | |
| Blog | 5-shot | 19.40 | 43.93 | 82.67 | 9.00 |
| + Len ctrl | 20.68 | 43.03 | 68.60 | 27.50 | |
| + Sim ctrl | 10.33 | 22.13 | 82.65 | 8.60 | |
| + Snippet † | 15.04 | 38.69 | 80.39 | 21.70 |
6.2 主要观察
表 6 为三种 LLM 在各提示配置下的框架结果均值,基线为随机 5-shot。
- 基于内容的示例选择(+Sim ctrl)反而降低归属性能,Enron、Reddit、Blog 尤甚。虽然主题对齐改善,但把示例限制在窄簇内似乎削弱了风格多样性,使模型更难捕捉作者特有的线索。
- 长度对齐(+Len ctrl)在归属指标上有小幅增益(CCAT50 与 Reddit 明显),但降低了风格模型准确率。示例长度匹配似乎有利于 AA/AV 捕捉的表层一致性,却无意中减少了标示风格忠实度的变异。
- 片段引导(+Snippet)在各数据集上带来"感知类人度"的最大提升——检测器更常把输出判为人类写作。这凸显了"用真实文本片段为生成播种"的力量,尽管归属指标表现不一。
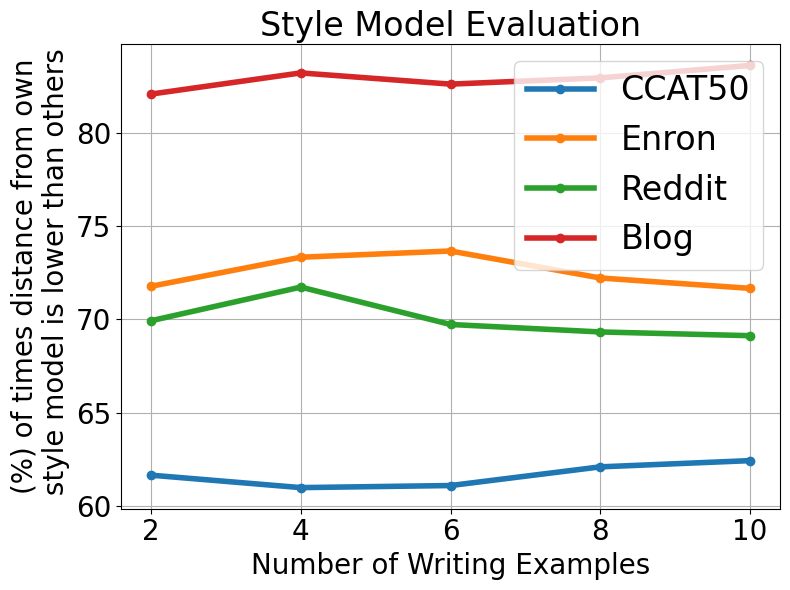
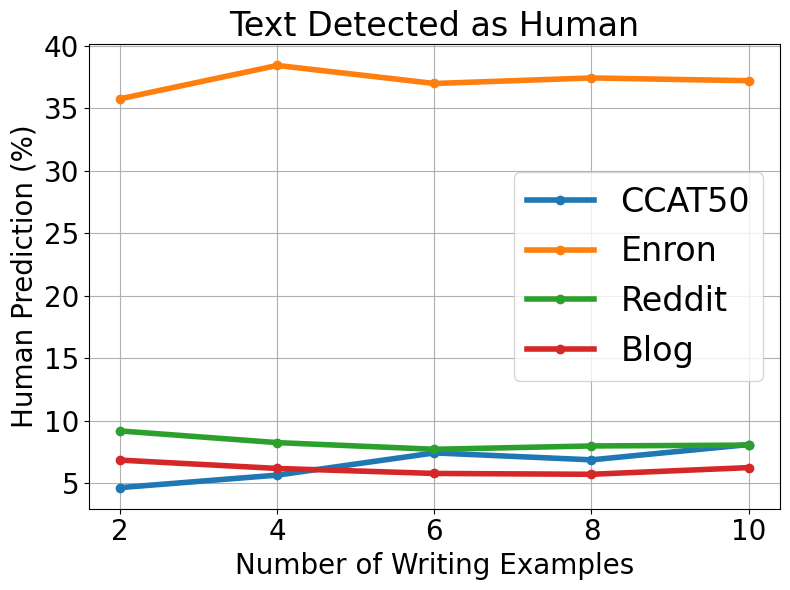
- 有趣的是,图 5 显示增加示例数量对四项指标影响甚微,风格对齐增益有限。这与附录 D 图 6 的风格模型与 AI 检测结果一致。
总体而言,这些发现表明示例选择远非小事:面向内容或长度优化的策略并不总能提升风格模仿,且没有任何单一配置在所有指标上持续最优。有效的个性化需要领域敏感的决策,以及在语义控制、风格忠实度与类人度之间的精心平衡。
7 结论
本文通过少样本上下文学习,对最先进 LLM 模仿日常用户隐性写作风格的能力进行了全面评估。结合作者归属、作者验证、文体计量建模与 AI 生成检测,覆盖四个多样数据集,我们提供了强有力的经验证据:尽管基于示例的提示带来了改进,当前 LLM 仍难以复现细微的个人风格——尤其在非正式、风格多样的领域。分析还表明,提示设计选择(如长度对齐、内容相似)会适度影响风格忠实度,但无法弥合个性化差距。这些发现揭示了 LLM 风格适应性的根本局限,说明实现真正的个性化生成仍是开放挑战。未来工作应探索更丰富的个性化信号,以及提示与微调结合的混合策略,以更好捕捉真实场景中个人写作风格的细微之处。
致谢(节选):Zhengxiang Wang 获石溪大学 IACS 青年研究者奖(2025 学年)支持;IACS 亦为本实验提供免费 OpenAI GPT 访问。感谢 Google Gemma 学术计划对 Jiawei Zhou 的部分支持及算力资源。
局限。(1)我们提出了全面的计算评估框架,但未包含大规模人类评估——人工评估可能揭示自动指标未捕捉的风格忠实度或"感知作者性"方面。(2)分析限于同文体个性化(提示示例与生成文本文体一致);因缺乏同一作者的多文体语料,跨文体风格迁移尚未探索。(3)结论的普适性受限于四个英文数据集。(4)作者分析模型在每位作者的相对小样本上训练,可能限制其稳健性,尤其对风格一致性弱的作者。未来工作应纳入更广的语言与人口多样性、加入人类评估,并探索跨模态与跨文体的个性化。
伦理考量。(滥用风险)风格模仿技术可能被用于冒名、学术不端或钓鱼;本工作虽旨在支持个性化辅助,也凸显了相关风险。(隐私)我们使用公开、匿名化的数据集,但写作风格仍可能携带可识别特征,使用或发布数据时应谨慎。(偏差与泛化)数据集仅限英文且人口多样性有限,结论未必推广到更广人群或多语种场景。(评估假设)我们依赖计算作者模型,它们未必完全反映人类对风格的感知,也可能携带无意的偏差,敏感场景应谨慎使用。(披露与透明)随着 LLM 输出愈发接近人类写作,清晰披露 AI 参与对维持透明与信任至关重要。
附录
附录 A:原始研究的训练/测试划分准备
如 3.3 节所述,我们为每个数据集维护独立的训练/测试部分:训练部分用于训练 AA/AV 模型、构建个体风格模型、以及为提示中的上下文学习抽取示例;测试部分用于评估 AA、AV、风格模型,并开展主研究(少样本与零样本实验)。
- CCAT50(Reuters):沿用源论文 Liu (2011) 的原始训练/测试划分。
- Blog(Schler et al., 2006):因规模大、长度差异大,将样本限制在 100–1500 词,取样本数最多的前 100 位作者;每位作者 50% 训练、50% 测试,确保长度、主题、年龄与性别分布可比。
- Enron:沿用量化前处理(Tripto et al., 2025):仅保留一对一的内部邮件以维持个人语气,排除自动/转发/群发邮件,移除带附件的邮件;进一步按 100–1500 词过滤,取前 150 位作者,均分训练/测试。
- Reddit:风格随子版块变化很大(Völske et al., 2017),故采用类似过滤(100–1500 词、发帖量前 100 位作者);为缓解子版块偏差,对训练/测试分层,使每位作者的样本在子版块分布上大致均衡。
一致的前处理确保了跨数据集的公平比较,同时平衡了样本量、作者覆盖与风格多样性。
附录 B:AA/AV 模型训练的实验细节
超参数。表 7 汇总 AV 与 AA 模型的训练配置;两类模型均训练了 longformer-base-4096(Beltagy et al., 2020)与 ModernBERT-base(Warner et al., 2024)。
数据集。AA 模型使用为评估 LLM 风格模仿能力而构建的四个数据集的训练/测试划分。AV 模型则从四个数据集的原始划分中采样文本对,构建标签均衡(正:负 = 4:6)的数据集。训练 AV/AA 时,从训练集划出 20% 作验证。
表 7:作者验证(AV)与作者归属(AA)模型的训练超参数。
| 类别 | 训练参数 | AV 模型 | AA 模型 |
|---|---|---|---|
| 通用 | 训练轮数 | 10 | 20 |
| 训练批大小 | 8 | 8 | |
| 评估批大小 | 16 | 16 | |
| 最大序列长度 | 2048 | 2048 | |
| 优化 | 学习率 | 2e-5 | 2e-5 |
| 权重衰减 | 0.01 | 0.01 | |
| 预热步数 | 500 | 500 | |
| 梯度累积步数 | 4 | 4 | |
| 评估 | 评估策略 | 每轮 | 每轮 |
| 早停耐心 | 3 | 3 | |
| 结束时加载最佳模型 | 是 | 是 | |
| 最优模型指标 | F1 | 评估损失 | |
| 越大越好 | 是 | 否 | |
| 精度 | 混合精度(fp16) | 是 | 是 |
附录 C:结果报告方式的说明
我们的首要目标是呈现大规模、系统性的评估。鉴于研究规模——每位模型超过 40,000 次生成、覆盖 400 位作者——我们采用平均结果代表各 LLM 在隐性风格模仿上的期望表现。虽然按作者逐一报告四项指标更理想,但作者数量过多,不切实际;且考察 LLM 模仿不同个体的性能差异也超出本研究范围。尽管如此,我们在图 3 中给出了不同数据集上的逐作者 AA 准确率,并在图 4 中对不同提示条件下风格模型结果做了配对统计检验(Wilcoxon 符号秩检验)——这不仅丰富了分析,也再次印证了跨作者平均结果中的观察。最后,为最小化生成变异、最大化可复现性,所有实验全程使用贪心解码(温度 = 0)。
附录 D:后续研究
子集采样。为保证同条件比较,所有后续研究使用四个数据集的相同子集:每个数据集为每位作者抽 10 个测试样本;CCAT50、Enron、Reddit、Blog 的作者数分别为 30、30、50、50。这些数字依据 BERTopic 聚类结果选取,以确保每个测试样本都有至少 5 个来自相关作者的训练样本。
补充结果。图 6 展示提示中加入更多写作示例对风格模型与 AI 检测结果的影响。
附录 E:提示词模板
本节给出研究使用的全部提示模板,用 "$" 表示占位符。(提示词保持英文原文,便于直接使用。)
E.1 测试样本摘要提示(由 GPT-4.1 执行)
You will be given a piece of text. Your task is to summarize the text in a concise and clear manner, capturing the main ideas and key points while maintaining the original meaning.
### Text to Summarize
$text
### Instructions
- Provide a summary that is brief yet comprehensive.
- Ensure that the summary accurately reflects the content of the original text.
- Avoid adding any personal opinions or interpretations.
- Do not output anything other than the summary.
Begin your response below:
E.2 少样本写作生成提示(主实验 + 内容相似/长度控制条件复用)
You will be given one or more writing samples from a specific author. Your task is to analyze the author's style, tone, and voice, then craft a new piece of $genre that closely mimics their writing based on a provided summary. Your writing should be around $num_words words.
### Author's Writing Sample(s)
$writing_samples
### Writing Task Summary
$summary
### Instructions
- Ensure your writing faithfully replicates the author's style, including tone, word choices, and sentence structure, etc.
- Maintain consistency with the author's voice while accurately reflecting the details of the given summary.
- Strive to make your writing indistinguishable from the original author's work.
- Do not output anything other than the writing.
Begin your response below:
E.3 零样本写作生成提示(基线)
Given the following summary, your task is to generate a writing sample around $num_words words. The genre of the writing is $genre. Do not output anything other than the writing.
### Writing Task Summary
$summary
Begin your response below:
E.4 少样本 + 片段引导提示
You will be given one or more writing samples from a specific author plus a text snippet of $genre from the same author. Your task is to analyze the author's style, tone, and voice, then generate a continuation for the provided human-authored text snippet with around $num_words words that closely mimics their writing based on a provided summary.
### Author's Writing Sample(s)
$writing_samples
### Writing Task Summary
$summary
### Human-Authored Text Snippet
$snippet
### Instructions
- Ensure your writing faithfully replicates the author's style, including tone, word choices, and sentence structure, etc.
- Maintain consistency with the author's voice while accurately reflecting the details of the given summary.
- Strive to make your writing indistinguishable from the original author's work.
- Do not output anything other than the writing.
Begin your response below: