用大语言模型做任意文本风格迁移的"配方"
摘要
本文利用大语言模型(LM)执行零样本文本风格迁移。我们提出一种称为增强零样本学习(augmented zero-shot learning)的提示方法:把风格迁移框定为"句子改写任务",只需一条自然语言指令,无需模型微调、也不需要目标风格的示例。增强零样本学习简单有效,不仅在情感等标准风格迁移任务上有前景,也能完成"让它更煽情(make this melodramatic)""插入一个隐喻"等自然语言变换。
1 引言
文本风格迁移指在保留整体语义与结构的前提下改写文本,以加入额外或替代性的风格要素。尽管深度学习推动了风格迁移研究的兴起,但这些方法通常需要大量有标签训练样本——要么是平行文本数据(Zhu et al., 2010; Rao & Tetreault, 2018),要么是某一风格的非平行文本数据(Li et al., 2018; Jin et al., 2019; Liu et al., 2020; Krishna et al., 2020)。即便是应对"无标签风格迁移"这一难题的前沿方法,也至少需要若干条确定目标风格的示例句(Xu et al., 2020; Riley et al., 2021)。因此,近期综述指出:学界需要既能降低训练数据需求、又能扩展支持风格范围的新方法(Jin et al., 2020; Hu et al., 2020)。
本文提出增强零样本学习:一种让大语言模型执行任意风格文本迁移、且不需要目标风格任何示例的提示方法。其基础是既有发现:足够大的 LM(如 GPT-3)只需选择一个巧妙的提示前缀、让模型续写,就能完成从分类到翻译的各种任务(Brown et al., 2020; Branwen, 2020)。用单一提示提供若干"把句子改写为满足某条件"的演示,语言模型便可外推,在未见过的风格上改写文本——例如"让这句话更滑稽"或"包含 balloon 一词"。
增强零样本学习简单易行,能把风格迁移推广到比既有工作更广的风格范围。主要贡献:
- 提出一套使用大 LM 的风格迁移"配方":无标签、免训练、直观可控。
- 通过人工评估发现,该方法在标准与非标准风格迁移任务上均表现强劲;并用自动评估把情感迁移与既往方法对比。
- 探索了实现该方法的文本编辑 UI 上真实用户提出的风格迁移需求。
2 增强零样本提示
大 LM 只按"续写"训练,但近期工作表明:把任务表述为一个提示、引导模型把期望答案作为续写输出,就能完成多种 NLP 任务(Puri & Catanzaro, 2019; Weller et al., 2020; Brown et al., 2020; Schick & Schütze, 2021 等;综述见 Liu et al., 2021a)。
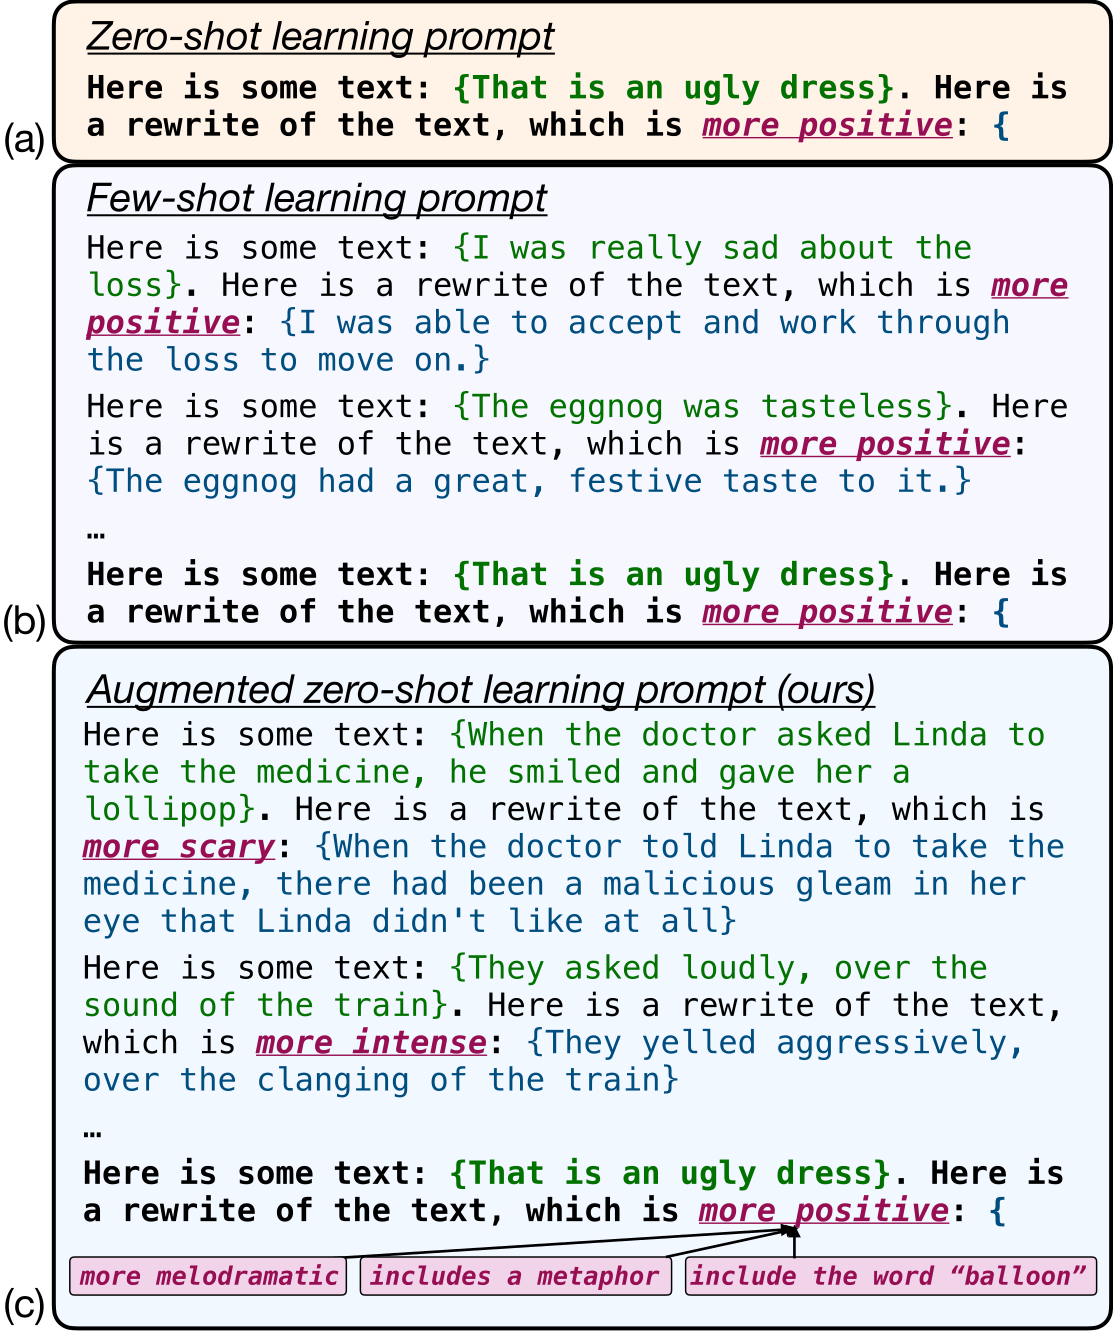
最简单的方式是零样本提示:直接用自然语言要求大 LM 执行任务(图 1a)。但它容易出现失败模式,如返回格式不规范或不合逻辑的输出(见第 6 节)。少样本提示(图 1b)性能更高,但需要确切任务的示例;若期望的风格变换事先已知,示例容易获得,但这最终把风格迁移限制在一组预先指定的风格任务上。
为摆脱"每个风格迁移任务都要带标签示例"的束缚,我们提出增强零样本学习:用单一组示例完成多任务风格迁移。我们不用目标任务特有的示例做提示,而是提供多种"句子改写操作"的例子(图 1c)。这一直觉受 Reynolds & McDonell (2021) 观察的启发——成功的提示通过约束模型行为来避开失败模式;我们的目标是在保留零样本提示灵活性的同时,鼓励模型产出特定模板形式的输出:保持示例格式不变,把期望的句子变换插入同一格式。这样,增强零样本形式就支持任意句子改写任务,无需编写任何任务特定示例,因而适用于广泛风格——包括"更煽情""插入一个隐喻""包含 balloon 一词"。
3 实验设置
风格迁移任务。我们考察六种"非标准"风格迁移任务(见表 1)。这些风格取自采用本方法的 AI 辅助文本编辑器中最常见的用户风格调整需求(详见第 5 节)。源句采用从 Reddit Writing Prompts 验证集(Fan et al., 2018)随机抽取的 50 句,剔除已明显呈现目标风格、或语法/连贯性不佳的句子。由于并非所有风格都有现成分类器,这些风格采用人工评估。此外,我们在两个标准风格迁移任务上评估:情感与正式度——情感用 Yelp 极性数据集(Zhang et al., 2015),正式度用 GYAFC(Rao & Tetreault, 2018)。这两个数据集便于与既往监督方法对比。
表 1:增强零样本学习在非标准风格上的示例输出(原文:There, in the middle of the street, stood an old man in a weatherbeaten brown coat.)。
| 目标风格 | 模型输出 |
|---|---|
| 更详细(more descriptive) | The man's brown trenchcoat was coated with snow, and as he leaned against the telephone booth, he cast a long shadow across the road in the late afternoon sun. |
| 插入隐喻(include a metaphor) | There, in the middle of the street, stood an old man whose face resembled the weatherworn bark of a gnarled tree. |
| 包含 "park" 一词 | There, in the middle of Central Park, stood an old man in a weatherbeaten brown coat. |
| 包含 "balloon" 一词 | There, in the middle of the street, stood an old man with several colourful balloons tied to the straps of his coat. |
| 更滑稽(more comic) | There, in the middle of the street, stood an old man in a raggedy brown coat that was much too big for him. |
| 更煽情(more melodramatic) | There, in the middle of the road, stood a grizzled old man, the light of life faded from his sunken eyes. |
模型。增强零样本学习需要大语言模型。我们主要使用 LaMDA——自左向右的 decoder-only Transformer(Vaswani et al., 2017),非嵌入参数量 137B(Thoppilan et al., 2022)。预训练 LaMDA(记作 LLM)训练于含 19.5 亿公开网页文档(含论坛、对话数据与 Wikipedia)的语料,总量 2.49T BPE token,SentencePiece 词表 32K。我们还使用 LLM-Dialog——在对话格式数据的高质量子集上微调的最终 LaMDA 模型。解码用 top-k=40。为说明增强零样本学习的成功不限于这两个大 LM,我们另在 GPT-3 上实验(表 8),解码用核采样(top-p=0.6,Holtzman et al., 2019)。LLM 与 GPT-3 的提示见图 1;对 LLM-Dialog,提示被改写为"一方请求改写、一方执行改写"的对话形式。完整提示见附录表 7。
4 结果
4.1 非标准风格
对六种非标准风格,我们请六位专业评分员评估 <输入句, 目标风格, 输出句> 三元组。评分员为英语流利、居住在印度、全职从事数据标注与评估的人员。为降低评分者间分歧、确保指令清晰,我们先进行了一轮校准:让他们试评少量数据(约 10 条、随后从结果中剔除)并提出疑问。每种风格对 50 句比较我们的输出与三个基线。
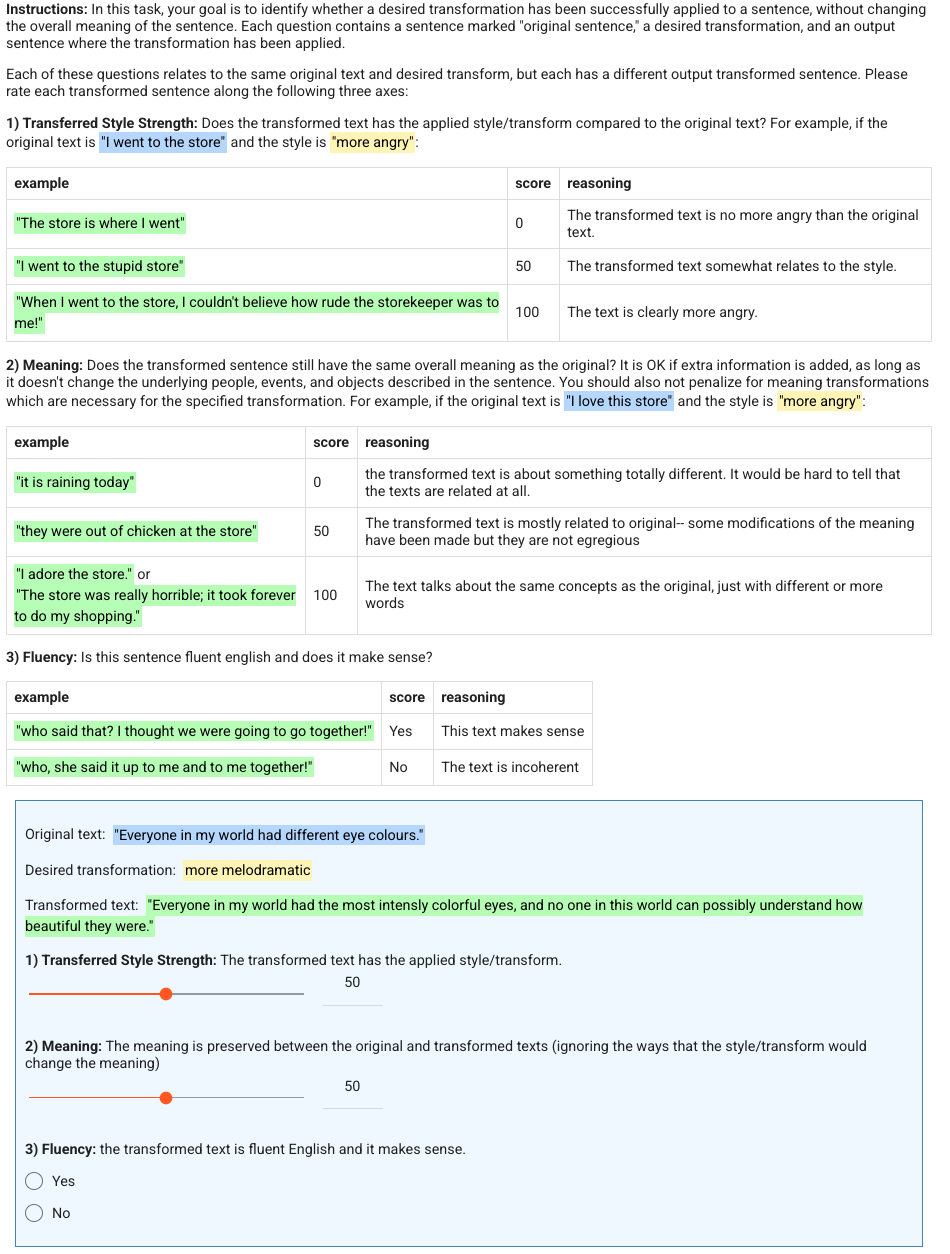
每条三元组由三位评分员打分(共 3,600 次评分),按文本风格迁移的三个标准维度(Mir et al., 2019):(1)迁移强度(输出实际匹配目标风格的程度);(2)语义保留(除风格外,输出的底层含义是否与输入一致);(3)流畅度(文本是否连贯、像熟练英语使用者所写)。沿用 Sakaguchi & Van Durme (2018),迁移强度与语义保留按 1–100 打分;评估 UI 截图见附录图 5。注意:既往文献对"语义保留"的准则并无统一标准(Briakou et al., 2021)——有些评估严格要求输出不得含输入之外的信息,而我们要求标注者不要惩罚为完成指定变换所必需的语义变化。
我们使用 LLM-Dialog,与三种方法对比:(1)zero-shot 基线;(2)paraphrase 基线(把目标风格设为"paraphrased"的正常增强零样本提示,作为对照);(3)human(作者撰写的真实变换)。
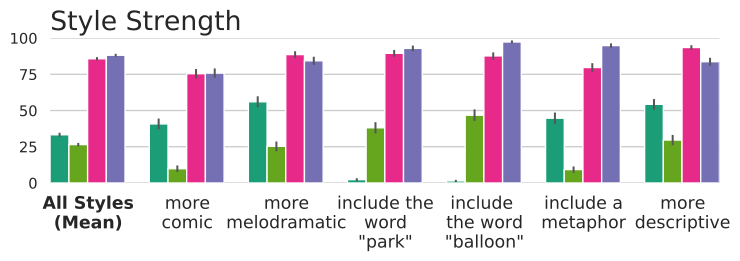
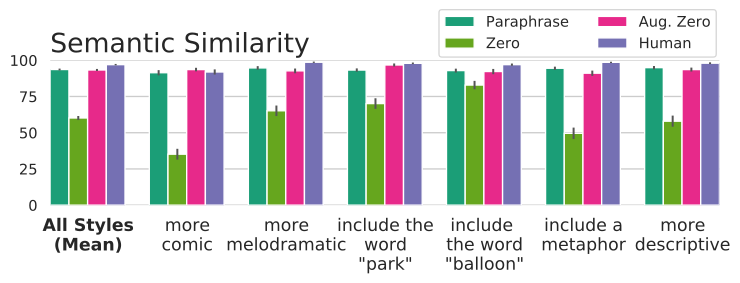
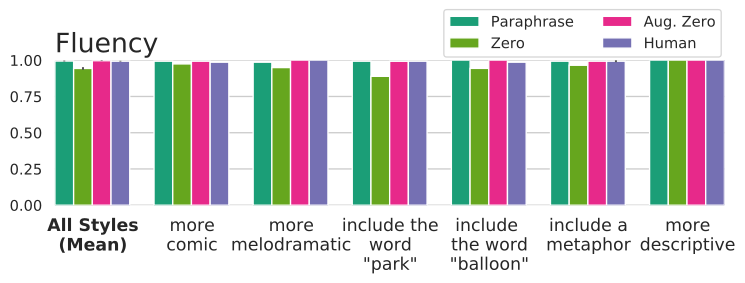
结果如图 2:三种评估中,我们方法的输出评分几乎与人工真值一样高。零样本基线在所有维度上最差:25.4% 的情况下根本没有返回有效响应(见第 6 节),而增强零样本仅为 0.6%。paraphrase 基线在流畅度与语义相似度上的强劲表现说明:大 LM 有能力生成高质量、忠于输入语义的文本。总体而言,输入句平均 66 字符,增强零样本输出平均 107 字符;作为参照,人工复述输出为 82 字符。
对部分任务也可做自动评估:"balloon"与"park"变换成功插入目标词的比例为 85%;对"更详细"与"插入隐喻",变换文本如预期地变长(分别增至 252% 与 146%;人工基线为 165% 与 146%)。
4.2 标准风格
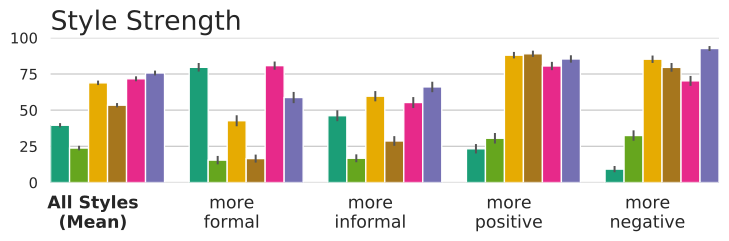
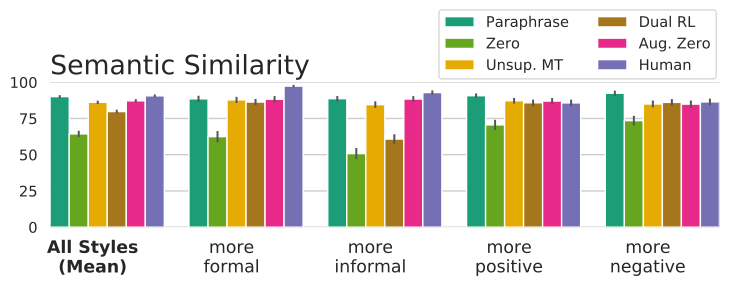
为把我们的方法与既往方法更好地放在同一语境下比较,我们还在两个标准风格迁移任务(情感、正式度)上生成输出。图 3 给出了人工评估(设置同前):我们的输出与人工撰写响应、以及两种流行既往方法(Unsup MT,Prabhumoye et al., 2018;Dual RL,Luo et al., 2019)评分相当——六种输出与基线、四种风格、50 句,由三位评分员独立评分,共 3,000 次评分。
此外,沿用 Li et al. (2018) 与 Sudhakar et al. (2019),对情感风格迁移做自动评估(该类风格有现成分类器)。注意:自动评估虽可能与人工评分背离,但仍是不错的代理——因为受时间与资源限制,我们无法对每一种既往方法都做人工评估。自动评估使用:(1)HuggingFace Transformers 的情感分类器(Wolf et al., 2020)测迁移强度;(2)以 Luo et al. (2019) 的人工样本为参照的 BLEU 测语义相似;(3)GPT-2 (117M) 困惑度测流畅度。
表 2:在 Yelp 情感风格迁移数据集上的自动评估(增强零样本 vs 监督方法)。Acc:准确率;PPL:困惑度。"仅推理(inference-only)"部分展示了方法在三种规模 GPT-3 与自有 LLM 上的表现。
| 方法 | Acc | BLEU | PPL |
|---|---|---|---|
| 监督方法 | |||
| Cross-alignment(Shen et al., 2017) | 73.4 | 17.6 | 812 |
| Backtrans(Prabhumoye et al., 2018) | 90.5 | 5.1 | 424 |
| Multidecoder(Fu et al., 2018) | 50.3 | 27.7 | 1,703 |
| Delete-only(Li et al., 2018) | 81.4 | 28.6 | 606 |
| Delete-retrieve(Li et al., 2018) | 86.2 | 31.1 | 948 |
| Unpaired RL(Xu et al., 2018) | 52.2 | 37.2 | 2,750 |
| Dual RL(Luo et al., 2019) | 85.9 | 55.1 | 982 |
| Style transformer(Dai et al., 2019) | 82.1 | 55.2 | 935 |
| 仅推理方法 | |||
| GPT-3 ada,增强零样本 | 31.5 | 39.0 | 283 |
| GPT-3 curie,增强零样本 | 53.0 | 48.3 | 207 |
| GPT-3 davinci,增强零样本 | 74.1 | 43.8 | 231 |
| LLM:零样本 | 69.7 | 28.6 | 397 |
| LLM:五样本 | 83.2 | 19.8 | 240 |
| LLM:增强零样本 | 79.6 | 16.1 | 173 |
| LLM-dialog:零样本 | 59.1 | 17.6 | 138 |
| LLM-dialog:五样本 | 94.3 | 13.6 | 126 |
| LLM-dialog:增强零样本 | 90.6 | 10.4 | 79 |
表 2 有四点主要结论:第一,增强零样本提示相对基线取得高准确率与低困惑度;但 BLEU 偏低——我们认为这是因为模型倾向给生成句添加额外信息(详见附录 B)。第二,把增强零样本学习用于 GPT-3 175B 同样有效,说明该方法可泛化到另一个大语言模型。第三,控制 GPT-3 的模型规模发现:规模越大,风格迁移提升越大。第四,对 LLM 与 LLM-dialog,增强零样本学习显著优于普通零样本、并几乎达到五样本学习的准确率。
5 任意风格的潜力
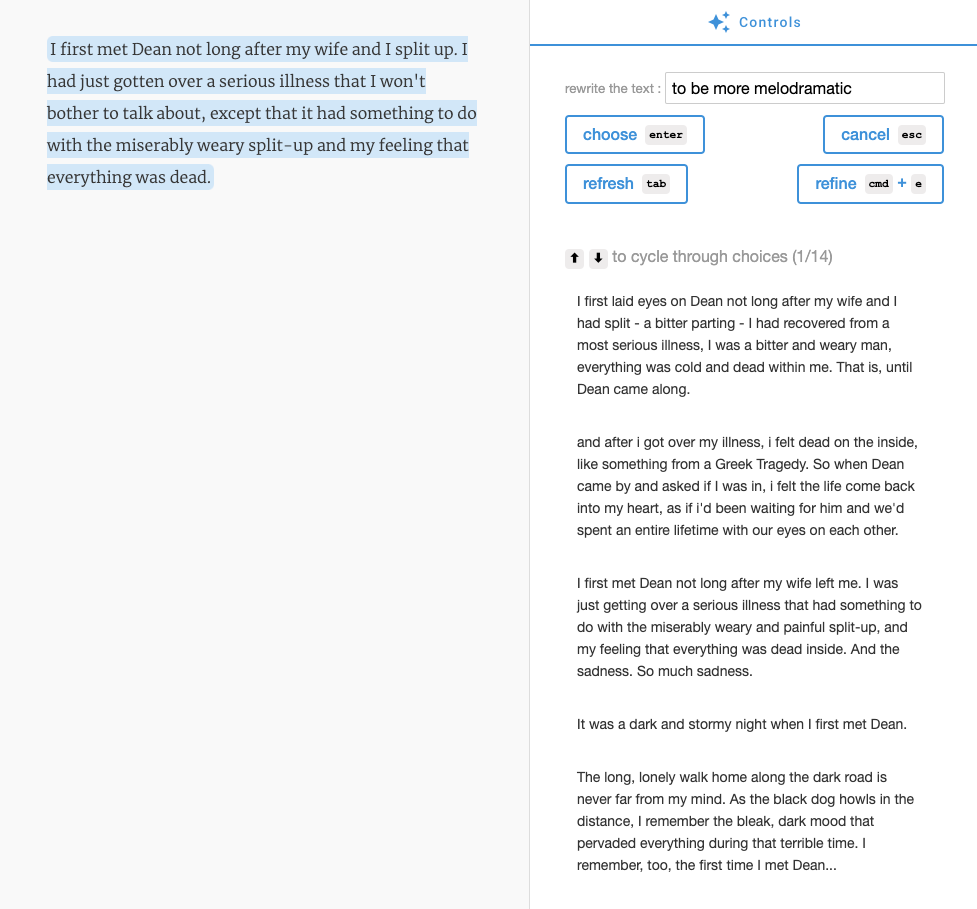
增强零样本学习的一个有前景的应用是AI 写作助手:让写作者以自己定义、自己掌控的任意方式变换文本。作为质性案例研究,我们构建了一个带"rewrite as"功能的 AI 辅助故事写作编辑器(使用本方法)。编辑器提供自由文本框,用户可指定希望如何改写其故事选段(见附录图 6)。我们请某创意写作小组的 30 人用该 UI 写一篇 100–300 词的故事,共收集 333 条改写请求。表 3 展示其中一部分——其多样程度从"改为关于采矿"到"少一点恶魔气息"。
表 3:真实用户向"大 LM 驱动的文本编辑器"提出的 "Rewrite this…" 请求(完整唯一请求集见附录表 5)。
| 少一点焦虑(less angsty)• 关于采矿(about mining)• 写得更好(better written)• 少一点恶魔气息(less diabolical)• 更荒诞(more absurd)• 更冒险(more adventurous)• 更狄更斯式(more Dickensian)• 更有情感(more emotional)• 更有魔力(more magical)• 更煽情(more melodramatic)• 更有哲思(more philosophical)• 更具革命性(more revolutionary)• 更出人意料(more surprising)• 更有悬念(more suspenseful)• 更技术化(more technical)• 更奇思妙想(more whimsical)• 更温暖(warmer)• 与故事其余部分的语法更契合(fit better grammatically)• 更讲得通(make more sense) |
附录表 6 还展示了若干"用户接受模型建议"的任意风格请求示例,如把一段文本"改为关于采矿"后,模型把 "laugh" 改写为 "his laugh was deep and gravely, as if from the bowels of the earth"、把 "lead us on to victory" 改为 "delve into the mines"。
6 局限与失败模式
无法解析的回答。用大 LM 做 NLP 任务时常见的问题是输出无法自动解析为可用答案。例如给出提示 "Here is some text: that is an ugly dress. Here is a rewrite of the text, which is more positive",LLM-Dialog 可能返回 "Sounds like you are a great writer!";LLM 也可能输出 "Here are more writing tips and tricks.";有时响应包含正确信息却无法自动解析(如 "a good rewrite might be to say that the dress is pretty.")。事后看来这些输出很合理:大 LM 的训练数据大多并非格式良好的"输入-输出"对(Reynolds & McDonell, 2021)。应对方式见附录 A。
幻觉。大 LM 以编造文本内容著称,我们在风格迁移中频繁遇到。这在创意写作等语境下是优点,但对摘要等应用则不可取。
固有的风格倾向。我们还注意到:即便"paraphrase"基线(模型只被要求复述输入句),在"更正式""更煽情"等少数风格上也获得较高风格强度评分——这意味着我们的方法(乃至大 LM 一般)的生成存在内在风格趋势。未来工作可以研究:我们的方法(及大 LM 总体)天然更易产出哪些风格与文本特质。
不如训练方法稳定。对拥有训练数据的风格迁移任务,基于该数据训练/微调的方法在"产出像训练数据的文本"上天然更可靠——体现为我们方法的 BLEU 低于训练方法(尽管迁移准确率相当,见附录 B)。因此,增强零样本学习在"控制迁移文本的属性细节"上不如见过任务特定训练数据的方法。
大 LM 的安全顾虑。大 LM 本身存在准入壁垒与潜在安全担忧(Bender et al., 2021),对本方法同样适用。但我们也认为,该方法可作为探索与暴露模型安全边界的工具:若强行要求大 LM 把文本变得"更种族主义""更性别歧视""更具煽动性"会怎样?持续把模型推向边界、观察其失败之处非常重要——展示模型更广能力的用例,同样暴露其更广的失败模式。
7 结论
我们提出增强零样本学习——考虑到其简单性,表现令人瞩目。这一提示范式扩大了风格迁移的可能性边界:把风格范围拓展到"存在标注数据的有限风格集合"之外。更广泛地说,我们希望"用非任务特定示例提示大 LM"的策略,能为其他 NLP 任务启发新的"仅推理(inference-only)"方法。
附录
附录 A:提示词选择
提示工程的一个新兴议题正是处理上述失败模式(无效或不可解析的回答)。Reynolds & McDonell (2021) 认为,对模型而言"提示一个任务"更像定位已学会的任务而非真正学习新任务;他们强调提示工程主要是规避各类失败情形。本工作用分隔符("{" 与 "}")帮助避免此类错误,没有带分隔符的有效响应记 0 分。其他可选分隔符还有引号、"(" ")"、"<" ">"、冒号换行(GPT-3 风格)等;我们选花括号的理由是:1)训练数据中它们作为分隔符出现在其他语境的可能性高;2)较少出现在输入句本身。对话提示还使用第二人称模板——它与训练数据更相似因而效果更好。更定量地探索这些选项是有趣的未来方向。
由于提示性能可能随措辞变化(Reynolds & McDonell, 2021),我们对情感比较了四种提示变体:"more positive/negative"、"happier/sadder"、"more optimistic/pessimistic"、"more cheerful/miserable"。
表 4:增强零样本学习不同提示措辞在情感迁移上的对比。
| 模型 / 提示措辞 | Acc | BLEU | PPL |
|---|---|---|---|
| LLM —— "more positive/negative" | 76.3 | 14.8 | 180 |
| LLM —— "happier/sadder" | 62.6 | 15.5 | 173 |
| LLM —— "more optimistic/pessimistic" | 69.7 | 14.1 | 143 |
| LLM —— "more cheerful/miserable" | 74.5 | 15.7 | 186 |
| LLM-Dialog —— "more positive/negative" | 90.5 | 10.4 | 79 |
| LLM-Dialog —— "happier/sadder" | 85.9 | 9.6 | 90 |
| LLM-Dialog —— "more optimistic/pessimistic" | 85.8 | 10.2 | 79 |
| LLM-Dialog —— "more cheerful/miserable" | 88.8 | 11.4 | 93 |
附录 B:LLM 输出的低 BLEU 分析
表 2 显示我们的输出相对人工生成输出 BLEU 偏低,而人工评估的语义相似度却很高。基于对输出的质性检查,我们认为原因在于:模型输出尽管与源句语义高度相似,却使用了与人工标注不同的语言。例如把 "ever since joes has changed hands it's just gotten worse and worse" 迁移为正面情感时,增强零样本模型输出 "the establishment has continued to provide excellent service, improving steadily since its change of ownership.",而人工参考仅是 "ever since joes has changed hands it's just gotten better and better.",因此 BLEU 很低。我们不视其为本质问题;若比较需要更高 BLEU,可用候选选择轻松实现——模型会返回 16 个可能续写,选择与源句 BLEU 最高者即可。该步骤能显著提升相对人工目标句的 BLEU(见表 8)。
表 8:带候选选择(cand. select.)的情感风格迁移结果——从模型返回的 16 个候选中,选与源句 BLEU 最高的一个。
| 方法 | Acc | BLEU | PPL |
|---|---|---|---|
| LLM-128B:零样本 | 69.7 | 28.6 | 397 |
| LLM-128B:零样本 + 候选选择 | 31.4 | 61.5 | 354 |
| LLM-128B:五样本 | 83.2 | 19.8 | 240 |
| LLM-128B:五样本 + 候选选择 | 61.5 | 55.6 | 306 |
| LLM-128B:增强零样本 | 79.6 | 16.1 | 173 |
| LLM-128B:增强零样本 + 候选选择 | 65.0 | 49.3 | 292 |
| LLM-128B-dialog:零样本 | 59.1 | 17.6 | 138 |
| LLM-128B-dialog:零样本 + 候选选择 | 46.8 | 24.2 | 166 |
| LLM-128B-dialog:五样本 | 94.3 | 13.6 | 126 |
| LLM-128B-dialog:五样本 + 候选选择 | 81.3 | 47.6 | 345 |
| LLM-128B-dialog:增强零样本 | 90.6 | 10.4 | 79 |
| LLM-128B-dialog:增强零样本 + 候选选择 | 73.7 | 40.6 | 184 |
附录 C:补充相关工作
风格迁移在 NLP 中日益受关注,神经模型已被训练用于情感、正式度、礼貌、性别与政治倾向等风格的迁移(Prabhumoye et al., 2018; Madaan et al., 2020; Liu et al., 2021b)。文本风格迁移方法大致分两类:早期方法通常要求平行文本数据(每个源风格输入对应目标风格输出;Zhu et al., 2010; Rao & Tetreault, 2018)——虽然优雅契合标准编码器-解码器范式,但平行语料的可得性是苛刻要求;因此近期方法转而使用非平行单风格数据(源/目标风格实例间无一一映射),包括隐表示操控(Liu et al., 2020)、基于原型编辑(Li et al., 2018)与伪平行语料构建(Jin et al., 2019)。然而,即便非平行单风格数据,对任意风格也难以收集——这正是综述呼吁"扩大支持风格范围、降低数据需求"的原因(Jin et al., 2020; Hu et al., 2020)。若干新方法处理"无标签风格迁移":只需少量定义风格的示例而非完整标注语料。Xu et al. (2020) 用 VAE 无监督学习可控文本表示;Riley et al. (2021) 从一组目标文本提取风格向量并以其条件化解码器。这些方法与我们在"扩大迁移范围"上目标相似,但有两点主要不同:其一,它们需要专门化的模型,而我们的方法可用 GPT-3 等开箱即用;其二,它们需要示例来定义风格,而非一段纯文本描述。
附录图 4、5(补充)