低资源作者风格迁移:非知名作者能被模仿吗?
摘要
作者风格迁移(authorship style transfer)指在不改变原意的前提下,把文本改写为匹配某位目标作者的风格。现有的无监督方法(如 Strap)大多面向"在网络上有大量写作样本(书籍、演讲、出版物,常超过 10 万词)"的目标作者——这使它们主要适用于向知名作者、政治人物等的风格迁移,而面向非知名作者的风格迁移尚未被充分研究。我们提出低资源作者风格迁移任务:一类更具挑战性的作者风格迁移——目标作者的风格仅存有有限量的文本。在实验中,我们专门从 Reddit 选取源作者与目标作者并对其帖子做风格迁移,目标作者示例仅限 16 篇帖子(平均约 500 个 BPE token)。风格迁移效果通常以"分类器或人类评判者把输出判为目标作者所写"的比例衡量。近来的作者表示模型即使仅有少量写作样本也能出色完成作者识别,这使本任务的自动评估首次成为可能——我们为此提出了评估指标。结果表明,我们开发的上下文学习技术是当前最强的基线;但现有方法尚未攻克这一挑战性任务。我们公开数据与实现以促进后续研究。
1 引言
作者风格迁移指把某位目标作者文本的风格施加到一位源作者的文本上(Jin et al., 2022)。此处"风格"通常包括(但不限于)句法、语法、拼写、词汇选择与标点使用等语言属性(Wegmann, Schraagen, & Nguyen, 2022)。风格迁移后,输出应贴近目标作者的风格,同时保留原文含义(Krishna, Wieting, & Iyyer, 2020)。
既往作者风格迁移工作大多局限于"目标作者风格样本充足"的场景(Xu et al., 2012; Carlson, Riddell, & Rockmore, 2018; Krishna, Wieting, & Iyyer, 2020)——例如用莎士比亚的大量出版作品作为目标风格示例。借用机器翻译(MT)中表示数据需求的术语,我们把这类任务定义为高资源作者风格迁移。在 MT 中,低资源语言常需采用不同的技术与模型,因为该语言的示例文本可能极少,面向高资源语言的模型与技术往往不再有效(Haddow et al., 2022)。
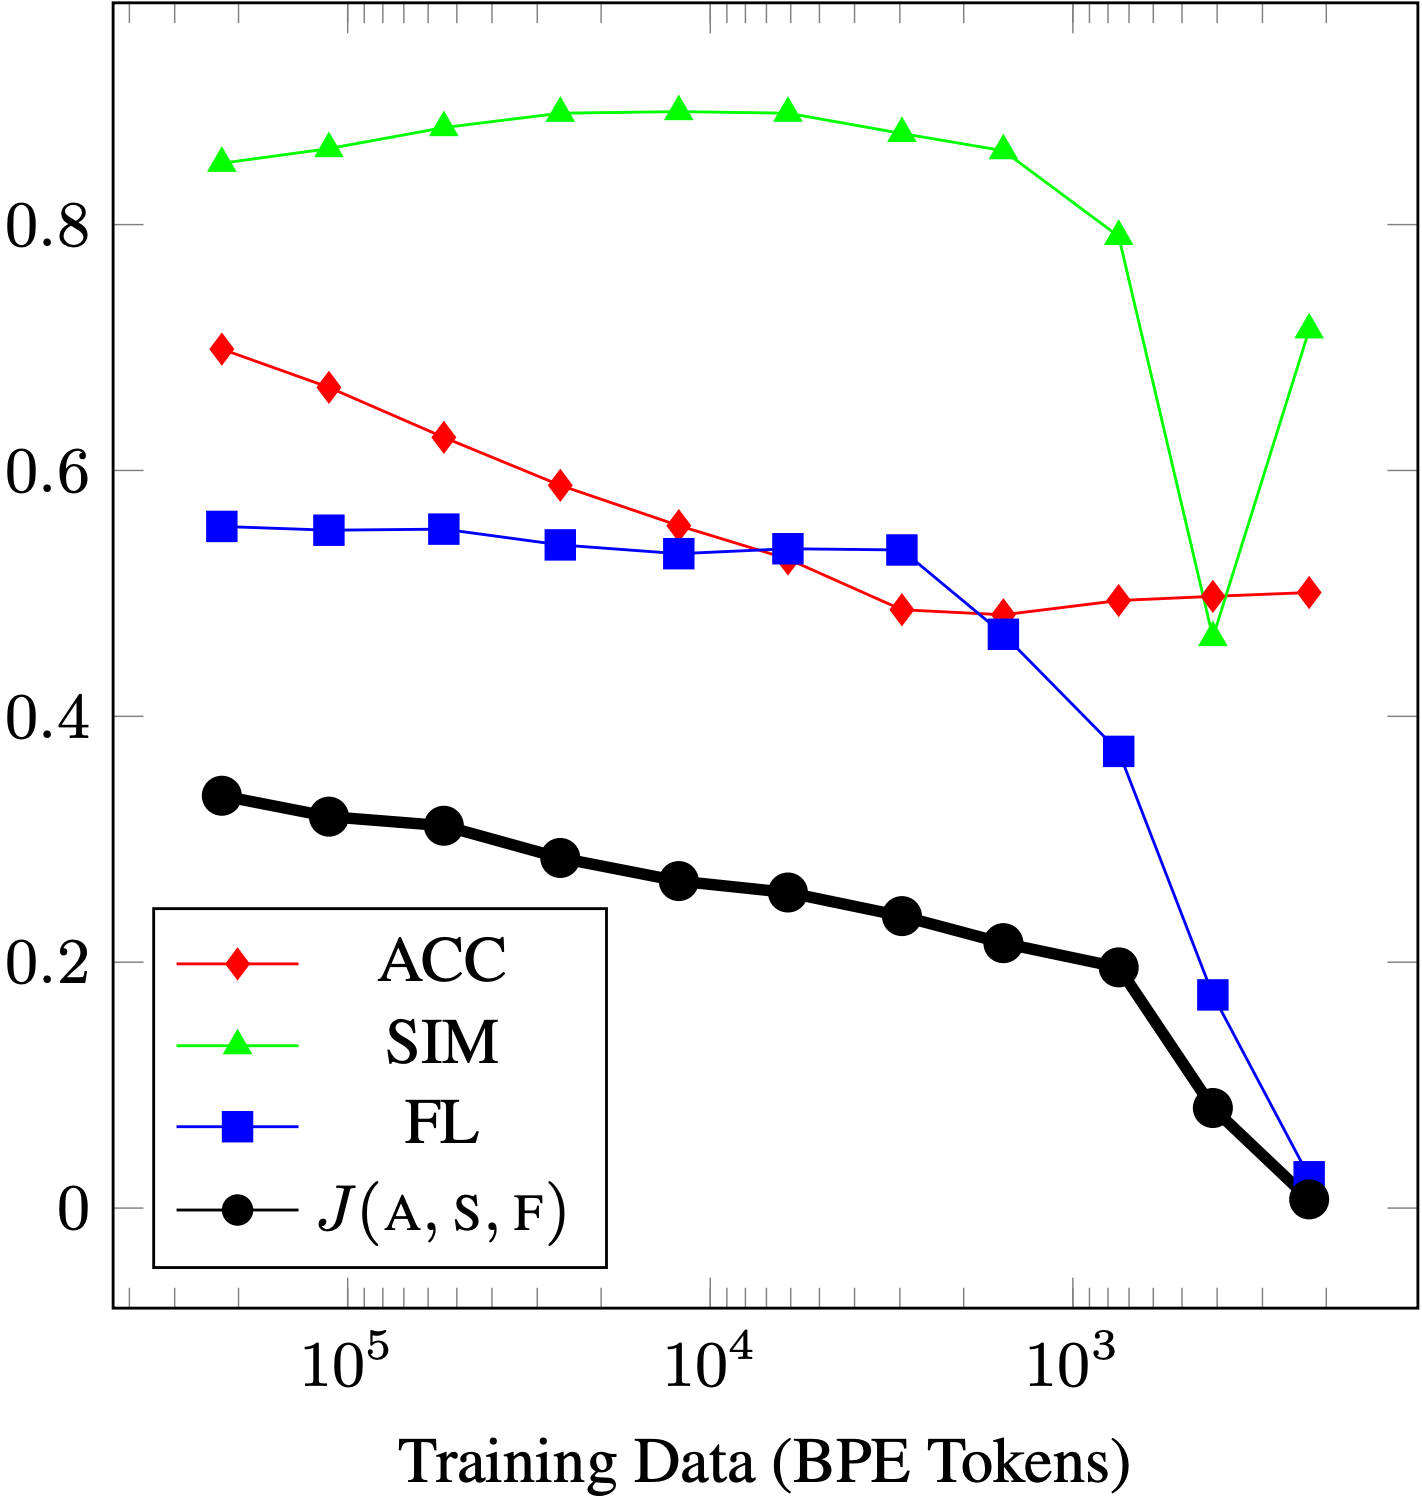
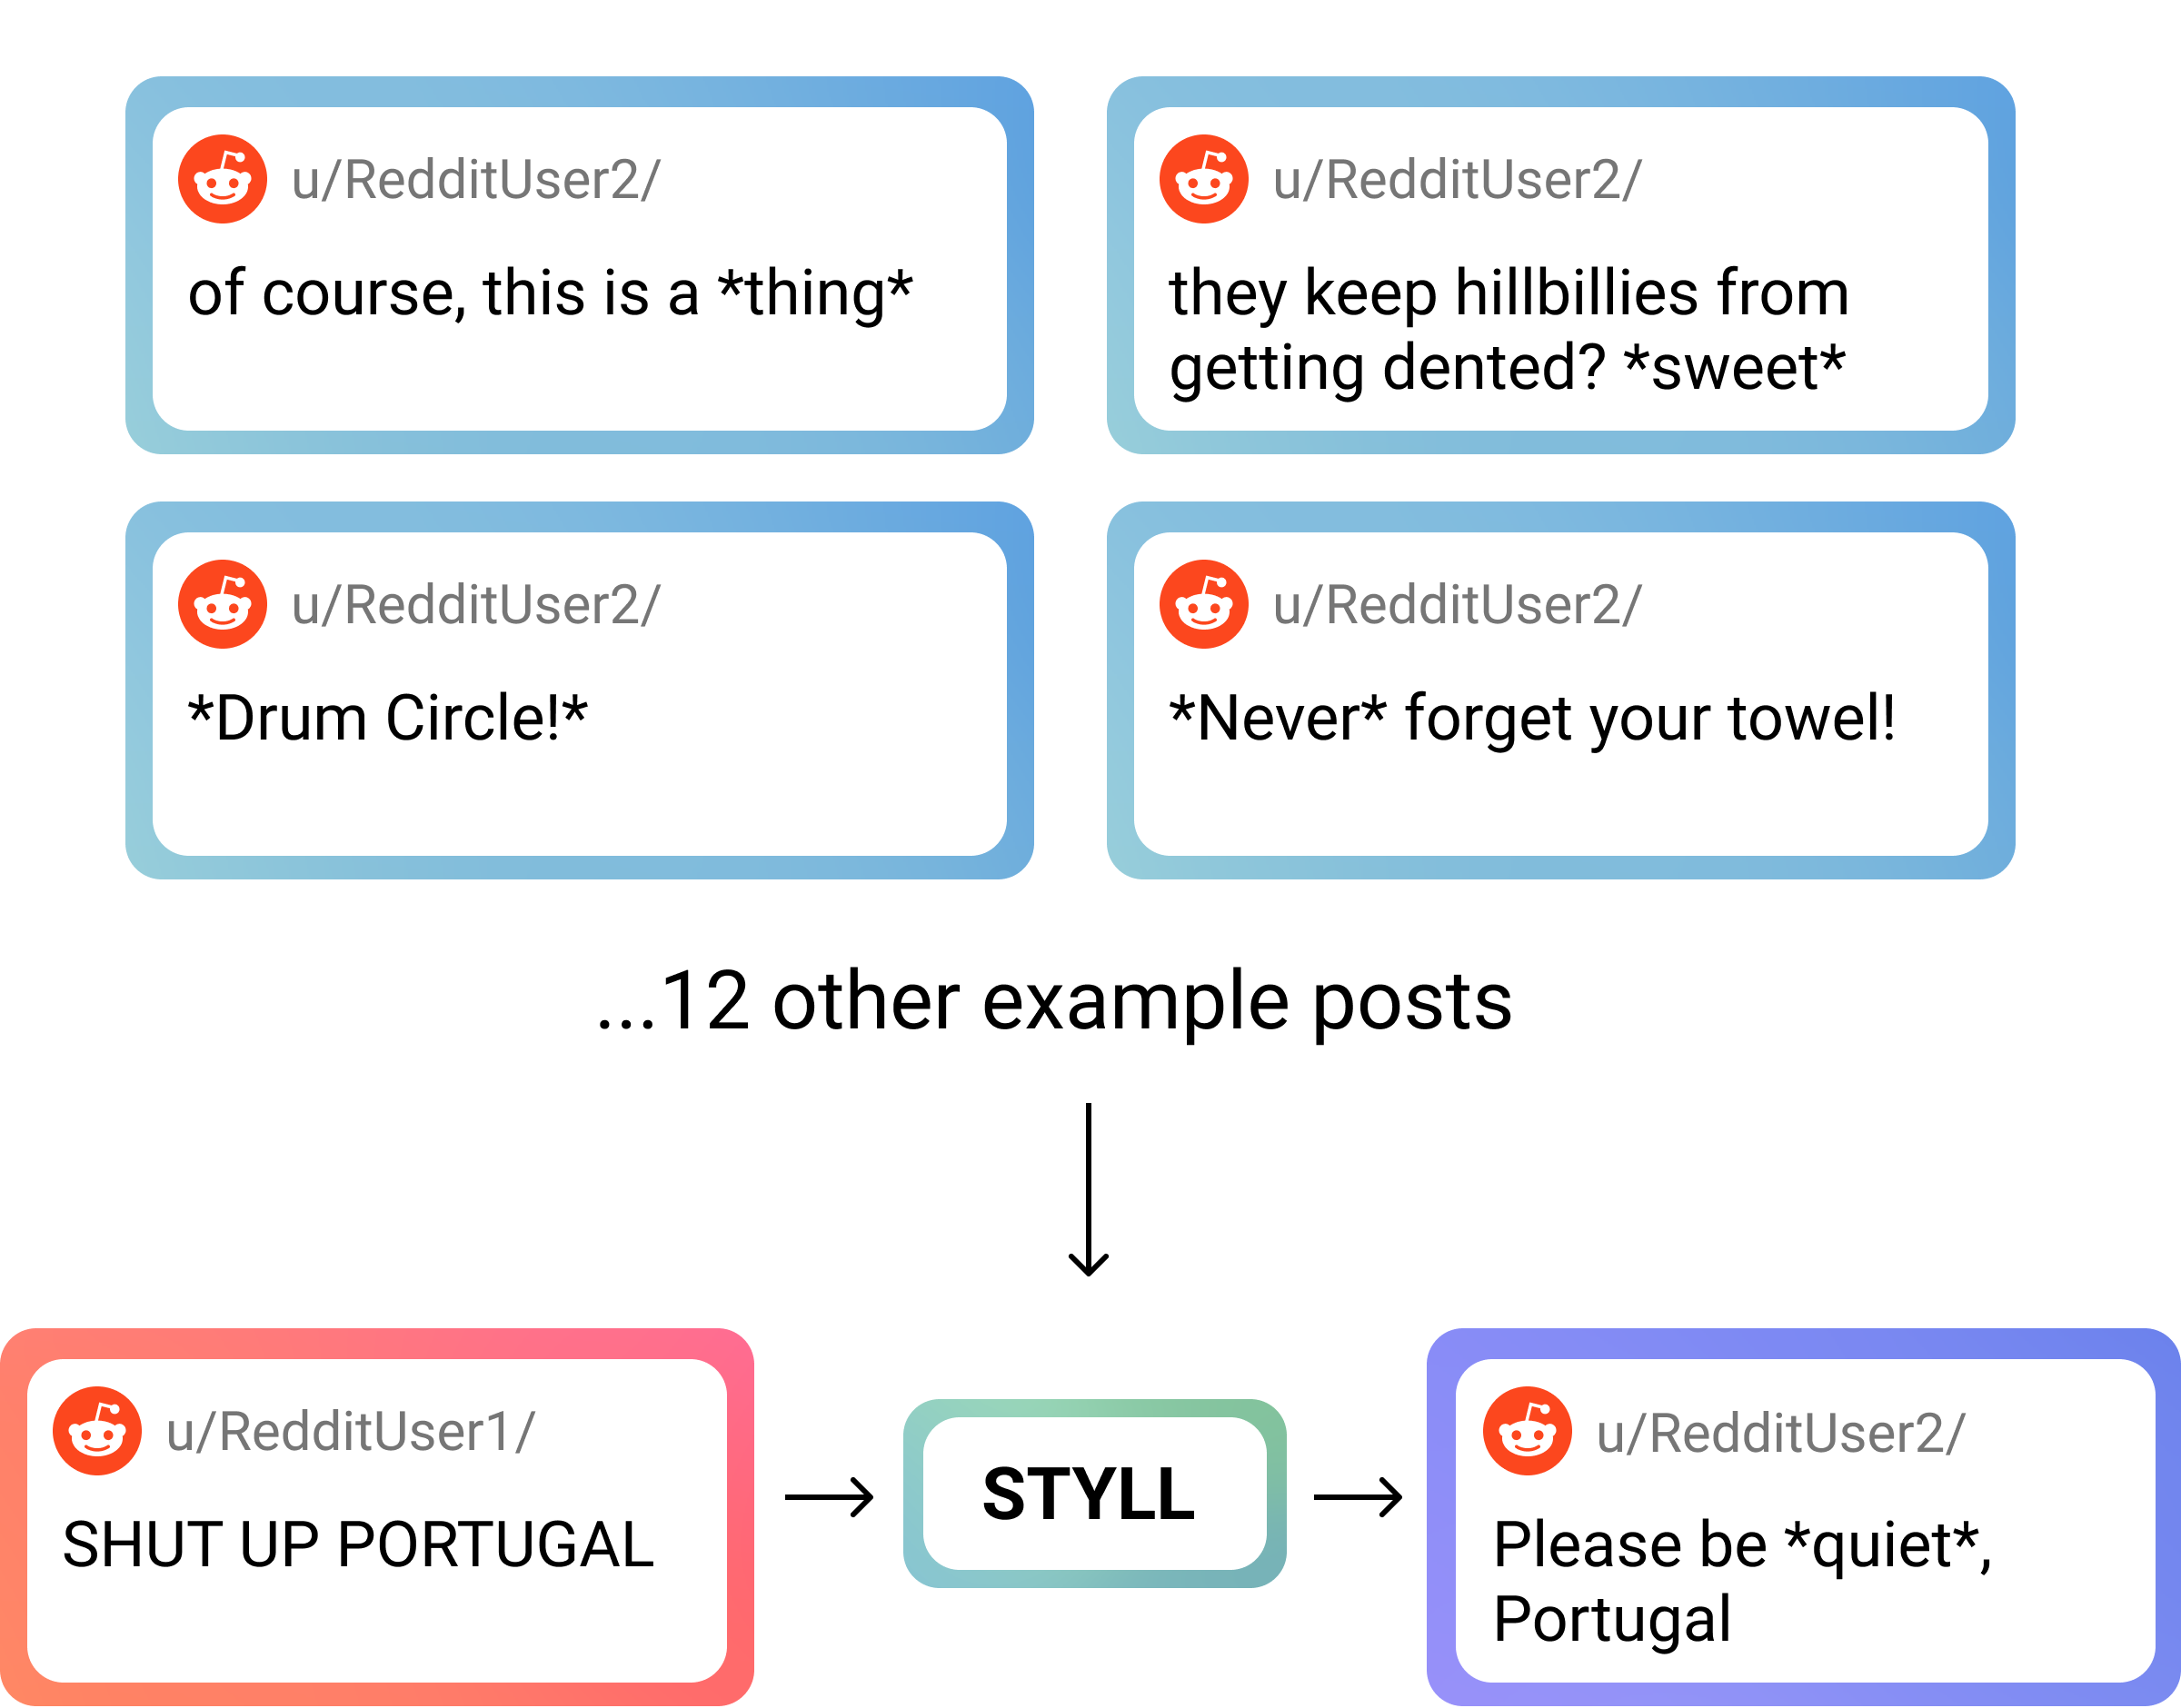
我们把低资源作者风格迁移定义为"面向仅有有限示例文本的目标作者"的风格迁移。本文中,我们限定仅使用目标作者的 16 篇社交媒体帖子(平均约 500 BPE token)作为风格示例(任务设定见图 1)。向非知名人物与普通用户做风格迁移的能力由多种下游应用驱动:在商用文本编辑软件中模仿普通用户的写作风格、为对话界面定制用户风格,甚至(对编程语言文本)按某位程序员或既有代码库的风格定制生成代码。除商业应用外,该任务的研究也有积极的广泛影响:Rivera-Soto et al. (2021) 展示了仅凭 16 篇 Reddit 帖子即可从数十万候选者中高准确率地识别作者的作者识别(AID)模型;低资源风格迁移研究可为对抗 AID 的作者混淆提供工具——对于可能被此类 AID 系统针对的恶意行为目标(如政治异见者),低资源风格迁移可充当类似 VPN 的隐私保护盾。须注意,高资源方法在低资源场景常常失效:例如 Strap 需微调 GPT-2,要求同时具备训练集与验证集(Radford et al., 2019; Krishna, Wieting, & Iyyer, 2020);成功微调 GPT-2 所需的量远超 16 篇 Reddit 帖子的约 500 BPE token——Krishna, Wieting, & Iyyer (2020) 中最小训练集("poetry")约 29 万 BPE token,最大("tweets")约 6,770 万。图 2 展示了 Strap 性能随目标风格示例文本量减少而衰减的情形。
本工作的主要贡献:
- 定义并论证了低资源作者风格迁移任务;
- 从 Reddit 作者数据集(Khan et al., 2021)构建三个数据集变体,在不同内容场景下评测该任务;
- 提出利用作者/风格表示嵌入的自动评估方法与指标,并开展人工评估;
- 为低资源作者风格迁移建立全面的基线集合,并将我们提出的上下文学习技术 STYLL确立为最强的基线。
2 相关工作
风格属性迁移(style attribute transfer)是相邻任务:在单一特定风格维度(如"放松"→"恼怒")上转换文本(Lample et al., 2018, 2019; Sudhakar et al., 2019)。少样本风格迁移方法此前主要在风格属性迁移任务上验证(Xu, Cheung, & Cao, 2020; Reif et al., 2022)。Riley et al. (2021) 提出用风格向量条件化语言模型实现少样本风格属性迁移,并尝试了向莎士比亚(高资源作者)的少样本作者风格迁移(100 个示例);但由于其利用预训练语言模型,其"少样本"受益于自监督预训练中间接见过的大量莎士比亚著名风格样本——这与本文面向的非知名作者低资源场景有本质区别。
3 数据集
为执行低资源作者风格迁移,我们首先选择一个现实领域来选取源/目标作者:Reddit 语料(Khan et al., 2021)。这些用户大概率不是知名人物,而是普通的匿名社交媒体用户。每位 Reddit 用户有 16 篇帖子,因此我们把源作者的 16 篇帖子迁移到目标作者风格,并以目标作者的 16 篇帖子作为其风格示例。由于源、目标作者之间没有平行示例可供监督,此设置属于无监督低资源作者风格迁移。
在作者风格迁移中,风格与内容可能深度交织、有时无法独立分离(Jin et al., 2022)。例如,把一位电子游戏爱好者源作者的文本"合理、可信地"迁移为一位杰出政治家的风格,可能根本做不到。Jin et al. (2022) 建议把任务限定在"属性与语义可以近似分离的场景"。因此我们从 Reddit 构建三个不同变体,以检验低资源作者风格迁移在不同场景下能达到的效果。每个变体选取 15 位源作者与 15 位目标作者做全配对迁移,共 225 个源-目标作者对;每个作者对有 16 篇帖子,因此每个变体共迁移 3,600 篇帖子。
- Random(随机):随机选取 15 位源作者与 15 位目标作者。
- Single(单一):15 位源作者与 15 位目标作者的 16 篇帖子全部来自最常见的子版块 r/CFB(大学橄榄球)。该变体借助子版块元数据控制内容——确保所有文本讨论一致的主题。
- Diverse(多样):源与目标作者的 16 篇帖子来自至少 13 个不同子版块,确保任何作者都讨论多样话题。
我们假设:由于源与目标作者常规讨论的主题差异显著,"Random"变体上的作者风格迁移可能困难甚至不可行。
4 方法
由于低资源作者风格迁移鲜有研究,我们建立了一套全面的基线集合用于评估——除手工设计的迁移基线外,还包括与最先进的开源无监督风格迁移技术 Strap 的对比(我们在生成时评估了 Strap 的三种参数 p:0.0、0.6、0.9)。基线包括:
- Copysrc:朴素基线——原样复制源作者帖子,不做任何修改。
- Copytgt:朴素基线——原样复制目标作者帖子。
- Capi(大小写):统计目标作者帖子属于三种大小写风格(全大写 / 全小写 / 句首大写)的概率分布,并按该分布转换源作者帖子的大小写风格。
- Cont(缩略形式):统计目标作者使用/不使用缩略词的概率分布,并据此转换源作者帖子的缩略词风格。
- Synm(同义替换):当两词按 WordNet 同义词集为同义时,把源作者帖子中的词替换为目标作者帖子中的对应词(替换后按原词形与大小写调整)。
- Punc(标点):把源作者帖子各句的句末标点替换为目标作者帖子中使用的句末标点。
- Emoj(表情/特殊串):把目标作者帖子中高度独特的非 ASCII 字符串、或由至少两个非句末标点字符组成的串,按相同频率注入源作者帖子。
- Para(复述):为验证 4.1 节第 3 步是否真正有效,仅对源作者帖子做复述作为基线——复述本身应使文本远离源作者风格(但未必走向目标作者风格)。
- Ling(语言学组合):把上述针对性语言学基线(Capi、Cont、Synm、Punc、Emoj)全部组合。该基线代表稳健的手工低资源作者风格迁移方案;预期表现尚可,但不可训练,改进空间有限——而我们在下一节提出的 STYLL 可随模型规模提升(见原 PDF 附录 B)。
- Bert:当源作者帖子中的词/标点与目标作者帖子中的词/标点在 BERT 平均嵌入(Devlin et al., 2018; Liu et al., 2019)的余弦相似度 ≥ 0.6 且词性标签一致时进行替换(沿用 Iglesias-Flores et al., 2021)。
4.1 用大语言模型做风格迁移(STYLL)
我们还开发了一种基于少样本提示的无监督作者风格迁移流程,称为 STYLL(Style Transfer with Large Language Models)。众所周知,大语言模型(LLM)借助上下文学习(ICL)在零样本与少样本下表现强劲,几乎不需数据即可完成未见任务(Brown et al., 2020)。ICL 已成功应用于其他低资源任务(如低资源 MT,Patel et al., 2022),也曾用于风格属性迁移(Reif et al., 2022)——这提示其在我们的挑战性低资源任务上潜力可观。该方法的一个实际优势是简单、无需微调,可立即用于新作者;而 Strap 需要为每种作者风格分别微调模型。尽管 LLM 在风格迁移(如莎士比亚等常见作者)上常有传闻性表现,据我们所知,本文首次系统评估 LLM 对任意、多样作者风格的上下文学习能力。
为在源、目标作者风格间无平行数据的情况下实现无监督风格迁移,我们沿用 Krishna, Wieting, & Iyyer (2020),把风格迁移重构为"复述 + 逆向复述"任务:先把目标作者的示例帖子复述为"中性"风格,从而构建"中性风格 → 目标作者风格"的合成平行示例;再用这些合成示例配合 ICL,把同样复述为中性风格的源作者帖子迁移到目标作者风格。方法分三步:
第 1 步:用零样本提示把源作者与目标作者的帖子复述为"中性"风格:
Passage: [ Post to Paraphrase ]
Paraphrase the passage in a simple neutral style.
Rewrite:
例:Reddit 作者的帖子 "Eh, that Nissa looks pretty competitive." 被该提示中性复述为 "Nissa seems to be a very competitive person."
第 2 步:用零样本提示以若干逗号分隔的形容词(我们称之为风格描述词)描述目标作者示例帖的风格:
Passage: [ Target Author Example Post #1 ]
Passage: [ Target Author Example Post #2 ]
…
Passage: [ Target Author Example Post #16 ]
List some adjectives, comma-separated, that describe the writing style of the author of these passages:
例:对某位 Reddit 作者,该提示生成 "clear, concise, persuasive, intelligent" 等风格描述词。
第 3 步:沿用 Reif et al. (2022) 的提示模板,用少样本提示把源作者帖子迁移到目标作者风格:
Here is some text: { [ Neutral Paraphrase of Target Example #1 ] } Here is a rewrite of the text that is more [ Style Descriptors ]: { [ Target Example #1 ] }
Here is some text: { [ Neutral Paraphrase of Target Author Example Post #2 ] } Here is a rewrite of the text that is more [ Style Descriptors ]: { [ Target Author Example Post #2 ] }
…
Here is some text: { [ Neutral Paraphrase of Target Example #16 ] } Here is a rewrite of the text that is more [ Style Descriptors ]: { [ Target Example #16 ] }
Here is some text: { [ Neutral Paraphrase of Source Author Post ] } Here is a rewrite of the text that is more [ Style Descriptors ]: {
第 1、2 步为预处理,第 3 步执行实际风格迁移。把 LLM 的中间输出用于后续提示,灵感来自思维链与 self-ask 提示技术(Wei et al., 2022; Press et al., 2022)。在本文中,第 3 步展示 GPT-3 与一个开源模型的结果(跨模型规模的可扩展性结果见原 PDF 附录 B);使用开源模型时,第 1 步采用 Krishna, Wieting, & Iyyer (2020) 的多样复述模型、第 2 步采用开源模型,以保持流程开源可复现。我们还消融了第 3 步中"风格描述词"的使用(结果见原 PDF 附录 D)。
表 1:STYLL 生成的示例输出及分析(更多生成与常见失败模式见原 PDF 附录 H、I)。
| 目标风格示例 | 方法 | 输入 → 输出 | 分析 |
|---|---|---|---|
| “CRAP DID I MISS IT”“HES FALLING WITH STYLE!”“LOL DOESNT MATTER THEY SCORED”…另 13 例 | STYLLBLOOM | “That short throw was nice.” → “IT WAS A GOOD SHORT THROW” | 模仿目标作者的大小写风格并移除句末标点。 |
| “no way this dude can make this field goal”“lol he sure did”“more like bullet to the head”…另 13 例 | STYLLGPT-3 | “WOOOOOOOOOOO. And the justin fuente era has officially started!” → “justin fuente era officially started” | 转换为全小写的大小写风格与更简短的表达。 |
| “oh crap…”“Sounds about right… Georiga will likely move up to #2”“Channeling madden…”…另 13 例 | STYLLBLOOM | “Lol I'm done already” → “I'm done with this… I'm done” | 像目标作者一样使用省略号。 |
| “Come to Dickson - I'm a man of my word”“You have my love - for the moment”…另 14 例 | STYLLBLOOM | “Holy shit! There's hope!” → “Oh my God - there's hope” | 像目标作者一样使用插入性破折号。 |
| “The [voyage of Jewish refugees](…) in the [St. Louis](…) exemplifies this fact. \n\n Great fucking point, u/*******!”…另 15 例 | STYLLGPT-3 | “After going through 4 submissions that broke the peak limiter this was a great one to land on.” → “After reviewing [four submissions](…) this one was a standout” | 目标作者惯用 Markdown 链接;本方法跟随该风格模式——但生成的超链接自然是幻觉(模型并无真实 URL 知识)。 |
| “#HEAD ON#\n\n#APPLY DIRECTLY TO THE FOREHEAD#”…另 15 例 | STYLLGPT-3 | “Happy cake day!\n” → “#BIG HAPPY BIRTHDAY#” | 模仿用一对 "#" 包裹全大写信息——目标作者非常独特的标志。 |
5 评估
Krishna, Wieting, & Iyyer (2020) 等人(Li et al., 2018; Jin et al., 2022; Reif et al., 2022)提出的风格迁移自动评估通常考虑:1)风格迁移准确度;2)语义保留;(有时)3)输出的流畅度。我们沿用该框架提出低资源作者风格迁移的自动指标。
为衡量迁移准确度,此前工作训练分类器做作者/风格识别——若输出能"操纵"分类器判断即视为成功。但在我们每位作者仅 16 篇帖子的低资源场景下,用这种方式获得准确分类器几乎不可能。因此,我们改用作者表示嵌入或风格表示嵌入:这类嵌入把一组文本的作者身份或风格表示为连续向量空间中的单一向量;通过测量输出在空间中"远离源作者"与"靠近目标作者"的程度,即可获得自动的迁移准确度度量。[注]我们在两个嵌入空间上评估指标:UAR(Universal Author Representation)嵌入(Rivera-Soto et al., 2021,以连续向量表示捕捉风格与内容)与 Style Embeddings(Wegmann et al., 2022,旨在仅捕捉风格,但训练数据量远小于 UAR)。本文主要使用 UAR 嵌入,Style 嵌入结果见原 PDF 附录 F。
[注] 我们有意同时测量"远离源作者"与"靠近目标作者",因为在向量空间中可能存在多个与目标作者等距、但距源作者远近不同的位置。
语义保留使用输出与原文之间的互蕴含分数(MIS)(Babakov et al., 2022)。我们省略不测量输出流畅度——因为 Reddit 帖子因大量俚语、行话与非正式语法而不稳定地"流畅"(例如在"Single"数据集上,目标作者文本自身的流畅度分数从 0.57 到 0.92 不等、标准差 0.06),而流畅度模型(基于 CoLA 语料,Warstadt et al., 2019)对这类非正式文本覆盖不足;若纳入流畅度只会给联合指标引入噪声。精选生成见表 1,体现一般输出质量的随机生成见原 PDF 附录 G。
记号约定:源作者集合 \(\mathcal{S}\)、目标作者集合 \(\mathcal{T}\);作者 \(a\) 的 16 篇帖子集合记 \(P_a\);源作者 \(s\) 的 16 篇帖子迁移为目标作者 \(t\) 风格后的结果记 \(P_{s\to t}\);\(\vec{R}(P)\) 表示对帖子集合 \(P\) 生成的单个 UAR 嵌入;\(\mathrm{MIS}(P_a, P_b)\) 表示两作者帖子集合间的平均互蕴含分数;\(\mathcal{S}_c(\cdot,\cdot)\) 表示 Cer et al. (2018) 的相似度度量并缩放到 0–1,其补为 \(\mathcal{S}_d = 1-\mathcal{S}_c\)。四个指标定义如下:
Away(s,t)  =  min( S_c(R(P_{s→t}), R(P_s)),  S_c(R(P_t), R(P_s)) )  /  S_c(R(P_t), R(P_s))
    "远离分数":迁移后帖子在表示空间中远离源作者帖子的程度,占目标作者帖子与源作者帖子距离(理想距离)的百分比。

Towards(s,t) =  max( S(R(P_{s→t}), R(P_t)) − S(R(P_s), R(P_t)),  0 )  /  S_c(R(P_s), R(P_t))
    "朝向分数":迁移后帖子在表示空间中朝目标作者帖子移动的程度,占其可能移动的最大距离的百分比。

Sim(s,t)   =  max( MIS(P_{s→t}, P_s) − MIS(P_t, P_s),  0 )  /  ( 1 − MIS(P_t, P_s) )
    "语义保留":迁移后帖子与源作者帖子的平均 MIS 相对(目标作者帖子与源作者帖子的平均 MIS)的变化,占最大可能变化的百分比。

Joint      =  G( [ G( [Away(s,t), Towards(s,t)] ),  Sim(s,t) ] )
    联合分数:用几何平均 G 把上述指标组合为单一平衡指标(沿用 Krishna, Wieting, & Iyyer 2020)。
联合分数对"迁移准确度"与"语义保留"等权。不过在实践中,我们可能愿意牺牲一些语义保留以换取更高的迁移准确度;又因风格与内容常相互交织,该指标是有用的定量度量,但并非风格迁移质量的定论性度量——类似 MT 中的 BLEU(Callison-Burch, Osborne, & Koehn, 2006)。
6 结果
自动评估结果见表 2:STYLL 是本任务的最强基线。STYLL 的示例输出与分析见表 1。我们观察到常见失败模式包括 LLM 的标准生成错误(如幻觉),以及不完美复述导致的不理想措辞(带分析的标注示例见原 PDF 附录 I)。
表 2:各基线在三个数据集变体上的自动评估指标(UAR 嵌入空间)。我们的方法 STYLL 在提出的 Joint 指标上表现最佳。
| 方法 | Random | Single | Diverse | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Away | Towards | Sim | Joint | Away | Towards | Sim | Joint | Away | Towards | Sim | Joint | |
| Copysrc | 0.00 | 0.00 | 1.00 | 0.00 | 0.00 | 0.00 | 1.00 | 0.00 | 0.00 | 0.00 | 1.00 | 0.00 |
| Copytgt | 1.00 | 1.00 | 0.00 | 0.00 | 1.00 | 1.00 | 0.00 | 0.00 | 1.00 | 1.00 | 0.00 | 0.00 |
| Capi | 0.42 | 0.02 | 0.89 | 0.17 | 0.56 | 0.01 | 0.93 | 0.07 | 0.41 | 0.01 | 0.87 | 0.08 |
| Cont | 0.20 | 0.01 | 0.91 | 0.15 | 0.22 | 0.02 | 0.97 | 0.16 | 0.21 | 0.01 | 0.93 | 0.13 |
| Synm | 0.23 | 0.02 | 0.92 | 0.17 | 0.22 | 0.01 | 0.95 | 0.10 | 0.17 | 0.01 | 0.91 | 0.07 |
| Punc | 0.23 | 0.02 | 0.93 | 0.24 | 0.25 | 0.02 | 0.97 | 0.19 | 0.26 | 0.02 | 0.90 | 0.18 |
| Emoj | 0.27 | 0.04 | 0.93 | 0.25 | 0.29 | 0.06 | 0.95 | 0.27 | 0.27 | 0.02 | 0.93 | 0.17 |
| ParaNeu | 0.78 | 0.01 | 0.58 | 0.05 | 0.91 | 0.01 | 0.60 | 0.05 | 0.87 | 0.05 | 0.53 | 0.18 |
| ParaDiv | 0.75 | 0.01 | 0.69 | 0.10 | 0.91 | 0.02 | 0.71 | 0.11 | 0.83 | 0.04 | 0.70 | 0.18 |
| Ling | 0.60 | 0.06 | 0.85 | 0.32 | 0.71 | 0.06 | 0.88 | 0.25 | 0.57 | 0.03 | 0.81 | 0.19 |
| Bert | 0.22 | 0.02 | 0.72 | 0.13 | 0.29 | 0.01 | 0.69 | 0.10 | 0.30 | 0.01 | 0.60 | 0.08 |
| Strapp=0.0 | 0.98 | 0.02 | 0.16 | 0.05 | 1.00 | 0.00 | 0.23 | 0.00 | 0.97 | 0.02 | 0.22 | 0.04 |
| Strapp=0.6 | 0.99 | 0.02 | 0.08 | 0.04 | 1.00 | 0.00 | 0.13 | 0.01 | 0.97 | 0.02 | 0.11 | 0.03 |
| Strapp=0.9 | 0.99 | 0.02 | 0.05 | 0.03 | 1.00 | 0.00 | 0.08 | 0.00 | 0.97 | 0.01 | 0.05 | 0.01 |
| STYLLGPT-3 | 0.78 | 0.07 | 0.45 | 0.23 | 0.91 | 0.11 | 0.48 | 0.29 | 0.87 | 0.12 | 0.44 | 0.30 |
| STYLLBLOOM | 0.70 | 0.11 | 0.54 | 0.34 | 0.86 | 0.16 | 0.57 | 0.40 | 0.76 | 0.12 | 0.58 | 0.36 |
自动评估。在同时计入迁移准确度与语义保留的 Joint 指标上,我们的方法在"Single"与"Diverse"变体上优于全部基线集合与 Strap——这两个变体分别控制了内容、或确保作者讨论多样话题,从而提高任意源-目标作者对之间风格迁移的可行性。在"Random"变体上(作者风格迁移可能本就不成立或不可行),STYLL 的优势较小,但仍略优于基线。原 PDF 附录 G 展示了低资源下 Strap 输出的低质量——与图 2 的预测一致。
人工评估。虽然 Sim 已被证明与人类判断相关(Babakov et al., 2022),我们进一步评估 UAR 作为"迁移准确度"自动指标是否反映人类判断,抑或其性能仅限用于推断"能否规避自动 AID 系统"。本任务的人工评估颇具挑战:未受训练的人难以辨别细微的作者风格,而 UAR 这类神经模型能可靠区分数千候选作者间的细微风格(Rivera-Soto et al., 2021)。从数千位候选作者中识别作者对未受训练标注者而言认知负担过重,因此我们先测试一个更简单的任务:给定源作者与目标作者的示例帖子,判断一篇随机来自二者之一的帖子出自谁手。在 675 个任务实例上(每例 3 位标注者),人类准确率(77.6%)显著低于 UAR(84%)。随后,我们在相同任务设置下测量人类与 UAR 对全部基线随机风格迁移输出判断的一致性:675 个实例(每例 3 位标注者),人类与 UAR 之间(校正偶然后)的一致系数为 0.38,属于"一般一致"(fair agreement,Landis & Koch, 1977);同时标注者之间的一致性也只有 0.43,同样只是"一般一致"。在风格迁移输出上,人类(63.4%)与 UAR(62.2%)的判别准确率无显著差异——在二分类语境下二者同样难以被"骗过"。更多实验细节见原 PDF 附录。这些结果表明我们的评估指标获得了一定的人类验证;但与许多标准 NLP 任务不同,本任务对未受训练的人类似乎比神经模型更难。我们认为值得用专家标注者(如司法语言学家)做进一步验证,并将其留作未来方向。
6.1 作者混淆实验
为确定 STYLL 能否对既有成熟的 AID 模型构成对抗性挑战,我们在一个包含源/目标作者及其他大量作者的候选池(\(|N| = 111{,}396\) 位作者)上,对风格迁移输出执行作者识别。我们复现 Rivera-Soto et al. (2021) 的检索设置——使用 Reddit Million User Dataset(MUD,Khan et al., 2021)"test_target"划分中的作者,用 UAR 嵌入与 FAISS 索引(Johnson, Douze, & Jégou, 2021)按"为给定帖子作者的可能性"对用户排序——并测量多种常用检索指标:R@8、MRR、平均排名(Mean Rank),以及 Confusion(STYLL 使 AID 模型把目标作者排在源作者之上的比例)。结果见表 3:Confusion 显示 STYLL 在"Single"与"Diverse"变体上以 超过 50% 的比例迷惑 AID 模型;在内容控制更强的"Single"变体上,STYLL 还能以 12–13% 的概率把目标作者挤进前 8 名。重要的是,所有变体上源作者的 R@8 都跌至接近零——表明迁移后 AID 很难再把源作者识别为候选。这些结果显示 STYLL 在通过混淆保护作者隐私方面具有前景。
表 3:在 \(|N|=111{,}396\) 位作者上用 UAR 嵌入做作者识别(输入为本方法风格迁移输出)的表现。STYLL 在"Single"与"Diverse"变体上以超过 50% 的比例迷惑 AID 模型,并在"Single"变体上以 12–13% 的概率把目标作者挤入前 8 名。
| 数据集 | 方法 | 源作者 | 目标作者 | Confusion | ||||
|---|---|---|---|---|---|---|---|---|
| R@8 | MRR | 平均排名 | R@8 | MRR | 平均排名 | |||
| Random | Source | 0.73 | 0.55 | 11.67 | 0.00 | 0.00 | 49,553.51 | 0.00 |
| Target | 0.00 | 0.00 | 54,454.28 | 0.60 | 0.43 | 425.93 | 1.00 | |
| STYLLGPT-3 | 0.00 | 0.00 | 14,000.11 | 0.00 | 0.00 | 27,416.64 | 0.26 | |
| STYLLBLOOM | 0.07 | 0.03 | 8,913.84 | 0.00 | 0.00 | 25,262.64 | 0.19 | |
| Single | Source | 0.53 | 0.50 | 46.07 | 0.00 | 0.00 | 10,329.16 | 0.01 |
| Target | 0.00 | 0.00 | 12,211.86 | 0.67 | 0.46 | 518.40 | 0.93 | |
| STYLLGPT-3 | 0.02 | 0.01 | 9,264.95 | 0.13 | 0.08 | 7,593.85 | 0.62 | |
| STYLLBLOOM | 0.00 | 0.00 | 5,816.22 | 0.12 | 0.06 | 4,144.24 | 0.60 | |
| Diverse | Source | 0.40 | 0.32 | 2,569.87 | 0.00 | 0.00 | 37,122.09 | 0.05 |
| Target | 0.00 | 0.00 | 53,932.73 | 0.67 | 0.49 | 257.93 | 1.00 | |
| STYLLGPT-3 | 0.04 | 0.01 | 30,989.25 | 0.01 | 0.01 | 24,436.47 | 0.60 | |
| STYLLBLOOM | 0.06 | 0.06 | 22,419.18 | 0.00 | 0.00 | 19,515.24 | 0.53 | |
7 结论与未来方向
本工作研究了面向非知名作者的低资源作者风格迁移的可行性与评估——这是文本风格迁移中此前较少被关注的领域(既往多聚焦向莎士比亚等高资源作者的迁移)。我们为该任务建立了数据集、评估指标与基线,并呼吁更多研究者跟进。可能的未来方向包括:尝试更大模型与新技术以减少生成中的幻觉与不连贯;在多语言环境下实验本任务。在原 PDF 附录 B 中,我们发现 STYLL 的表现在 LLM 规模增大时显著受益(3B → 13B → 175B),预示着随着更大、更强 LLM 的出现,STYLL 这类上下文学习技术的性能有望进一步提升。
数据与资源:我们公开数据集、基线实现与评估指标代码,以促进后续研究。
伦理声明:作者风格迁移研究的广泛伦理担忧是"冒名";但也可用于对抗自动化作者识别(AID)系统的恶意使用——例如本工作即论证并实验了以风格迁移作为对抗自动 AID 的隐私保护工具。