TinyStyler:利用作者嵌入的高效少样本文本风格迁移
摘要
文本风格迁移的目标是在保留原意的前提下转换文本风格,且往往只有目标风格的少量示例。现有风格迁移方法通常依赖大语言模型(LLM)的少样本能力,或依赖复杂可控文本生成方法——后者效率低且在流畅度指标上表现不佳。我们提出 TinyStyler:一种轻量而有效的方法,利用一个小语言模型(800M 参数)与预训练作者嵌入,实现高效的少样本文本风格迁移。在具有挑战性的作者风格迁移任务上,TinyStyler 优于 GPT-4 等强力方法。我们还通过自动与人工评估检验了其文本属性风格迁移(正式 ↔ 非正式)能力,发现其优于近期可控文本生成方法。模型已公开发布。
1 引言
文本风格迁移(TST)指把源文本转换为匹配目标风格的文本,同时保留原意(Jin et al., 2022; Krishna et al., 2020; Patel et al., 2022; Horvitz et al., 2024)。目标风格可由多种方式定义,包括属性(如正式度)或作者身份(如奥巴马)(Jin et al., 2022)。构建风格迁移系统的一个难点是不同风格之间缺乏平行数据(Krishna et al., 2020)。对作者风格迁移等任务,目标风格可用的数据甚至可能极少(如面向非知名作者)——这构成了额外挑战(Patel et al., 2022),并推动了少样本方法的发展。
近来一些风格迁移方法依赖提示大语言模型(Patel et al., 2022; Reif et al., 2022)。与以往方法不同,这些基于 LLM 的方法能在任意目标风格、仅少量示例的条件下表现良好。但它们依赖的上下文学习(ICL)能力只有在大模型规模化后才可靠涌现(Radford et al., 2019; Wei et al., 2022; Lu et al., 2023);使用这些大模型再加上塞满上下文示例的长提示,效率低下,限制了方法的实际可用性。尽管 Suzgun et al. (2022) 表明推理期重排序可以改善较小模型的风格迁移表现,他们也显示仍有明显性能差距——对较罕见的目标风格尤其如此。
近期可控文本生成方法提供了替代方案:用小模型对风格特征做细粒度控制(Khan et al., 2024; Horvitz et al., 2024; Mireshghallah et al., 2022);但这些方法依赖缓慢的采样过程,或容易出现不流畅,且比提示 LLM 复杂、笨重得多。
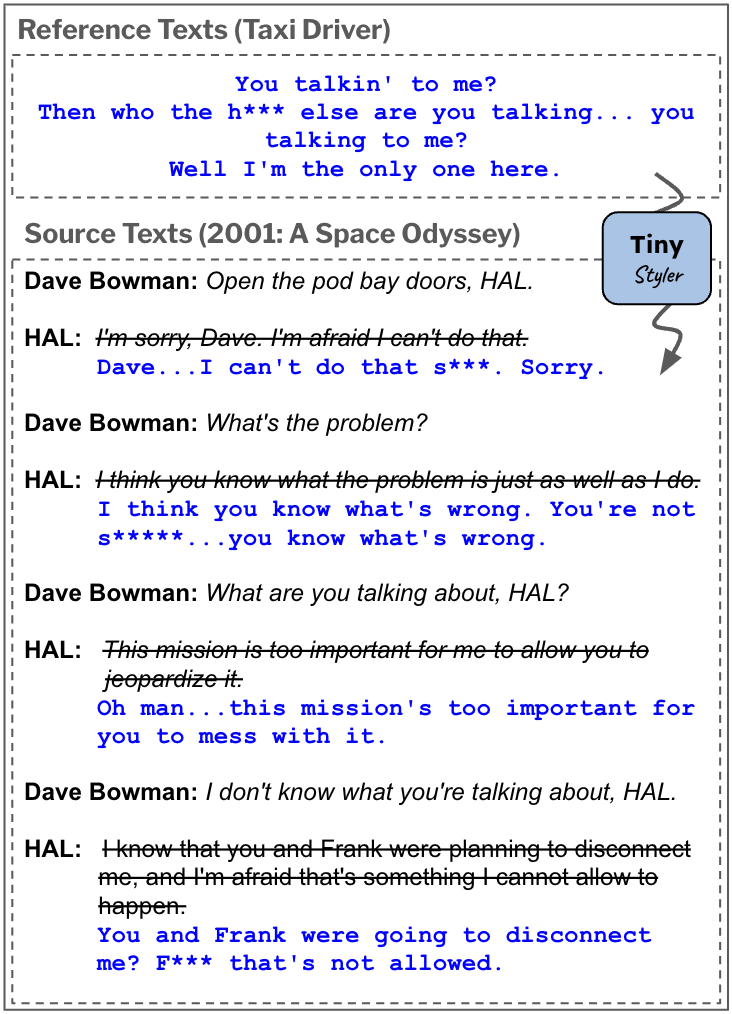
本文提出 TinyStyler:一种简单高效的少样本风格迁移方法,利用小语言模型与近期作者表示(authorship representations)的进展(Wegmann et al., 2022; Rivera-Soto et al., 2021)。TinyStyler 以无监督方式在大型多样语料上训练:以原文的作者嵌入为条件,从"复述"重建原文。推理时,只需以一个新的目标风格的作者嵌入为条件,即可完成少样本风格迁移。受 RAFT(Dong et al., 2023)启发,我们进一步通过"大量采样迁移文本 → 用自动指标过滤 → 在高质量对上微调"来提升性能。最终方法既能与最先进 LLM 持平,又可通过目标风格嵌入的插值实现细粒度控制。
贡献总结:
- 提出 TinyStyler——一种快速、高效、性能强劲的基于作者嵌入的少样本风格迁移方法。
- 在作者风格迁移与正式度风格迁移任务上评估:TinyStyler 优于或可媲美 GPT-3.5、GPT-4 等强基线,且优于近期可控风格迁移方法。人工评估证据表明,TinyStyler(仅 800M 参数)是相对于最先进 LLM 与上下文学习的高效替代。
- 以"源风格嵌入与目标风格嵌入之间的插值"为条件,TinyStyler 可细粒度地在"风格迁移准确度"与"语义保留"之间权衡,从而兼具近期可控生成方法(Khan et al., 2024; Horvitz et al., 2024; Mireshghallah et al., 2022)的诸多优点。
2 相关工作
无监督风格迁移。"以文本重建为框架、在源/目标风格无平行样本时执行无监督风格迁移"是既有工作中成熟的范式(Krishna et al., 2020; Riley et al., 2021; Jangra et al., 2022; Horvitz et al., 2024)。本文基于 Krishna et al. (2020) 的框架:先用复述中性化文本风格,再训练一个重建模型学习"重新赋予风格"。与"每种目标风格训练一个模型"不同,我们以目标风格的表示为条件,用单一模型完成向不同目标风格的迁移(类似 Riley et al., 2021);与两者都不同的是,我们利用了强预训练作者嵌入(Wegmann et al., 2022; Rivera-Soto et al., 2021)所捕获的信息。
基于 LLM 的少样本风格迁移。近期多种方法用 LLM 与上下文学习做风格迁移(Patel et al., 2022; Reif et al., 2022);Suzgun et al. (2022) 研究了用重排序提升较小 LLM 的输出质量;另一些方法从大 LLM 向小模型做知识蒸馏(Saakyan & Muresan, 2023; Zhang et al., 2024)。
可控文本生成。另一条近期工作把可控文本生成用于风格迁移(Horvitz et al., 2024; Khan et al., 2024; Kumar et al., 2021; Mireshghallah et al., 2022; Dale et al., 2021)。文本扩散方法(如 ParaGuide,Horvitz et al., 2024)与 MCMC 方法(如 Mix & Match,Mireshghallah et al., 2022)能提供细粒度风格控制,但其非自回归采样过程意味着更长的推理时间与更高的不流畅输出风险。
3 TinyStyler
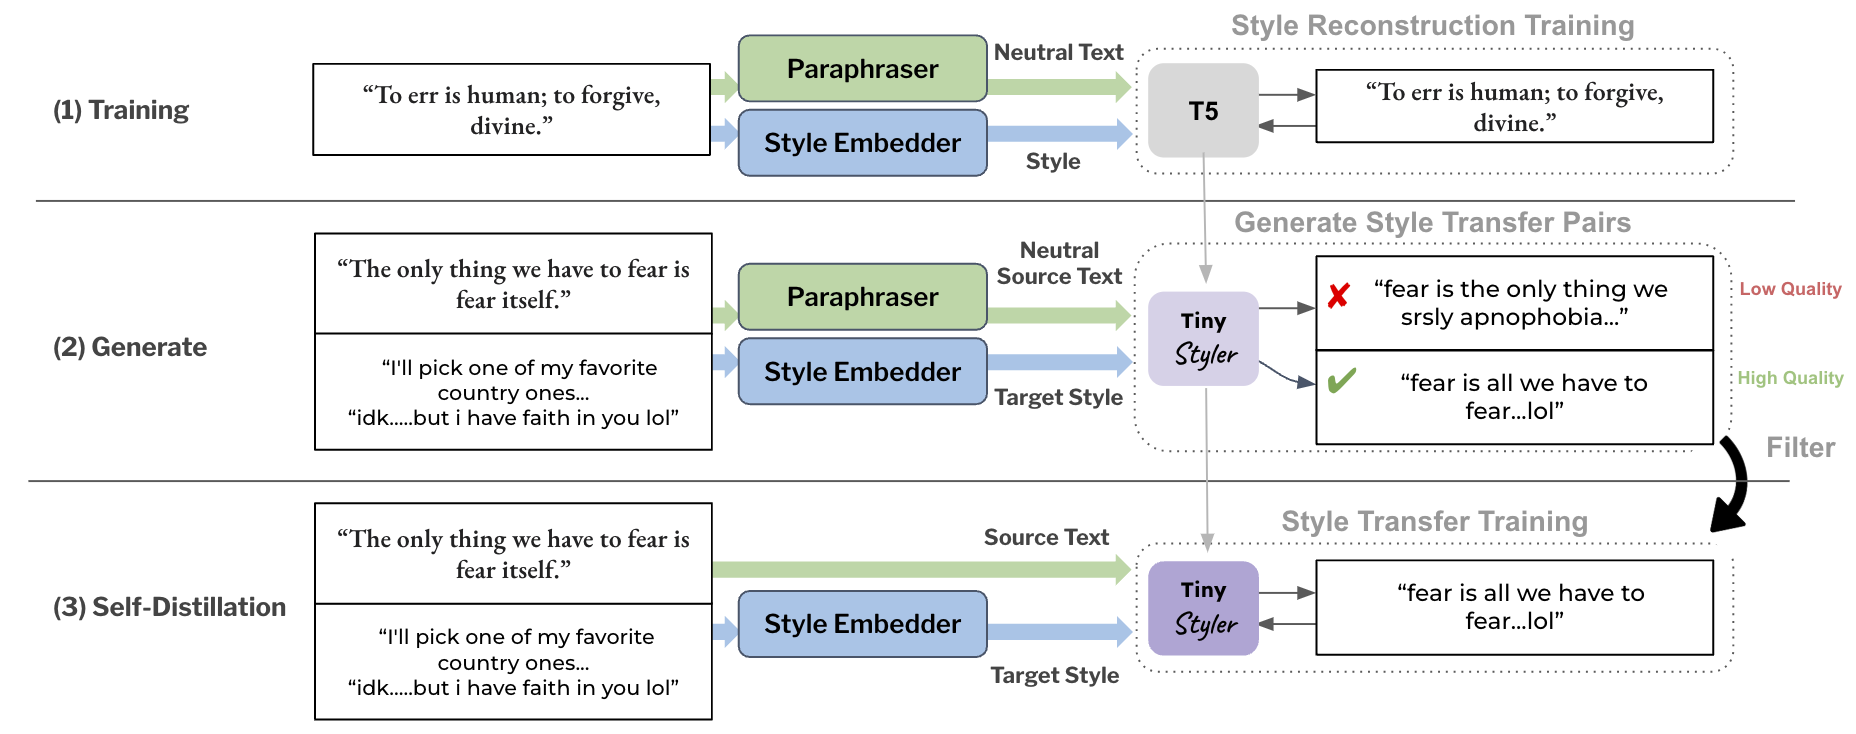
我们的风格迁移方法围绕"文本重建"构建。沿用既有工作(Krishna et al., 2020; Patel et al., 2022; Horvitz et al., 2024),我们用复述中性化文本风格、同时保留原意。3.1 节训练单一模型从"复述 + 预训练作者嵌入"重建文本;3.2 节说明如何用训练好的重建模型、以目标风格文本的新作者嵌入为条件,将源文本转换为任意目标风格,并据此构造高质量合成迁移对数据集;3.3 节做自蒸馏,提升一致性并摆脱对独立复述模型的依赖。流程见图 2。
3.1 风格重建训练
沿用 Krishna et al. (2020),先训练模型从"风格被中性化的复述"重建文本。我们不为每种目标风格训练独立模型,而是训练单一重建模型,以"复述 + 源文本的作者嵌入"为条件(图 2 步骤 1);随后在 3.2 节利用该模型构建风格迁移数据集,训练更强、更简单的管线。
数据集。训练通用重建模型需要覆盖多样作者风格的语料。我们使用 Reddit Million User Dataset(MUD,Khan et al., 2021)的子集(含千万级 Reddit 用户评论):每个用户名采样若干随机评论,过滤超过 128 token 的评论,最终数据集约含 440 万条评论。
作者嵌入。我们考察两种在连续空间中学习作者写作风格神经表示的方法:1)Style Embeddings(Wegmann et al., 2022);2)UAR(Universal Authorship Representations)(Rivera-Soto et al., 2021)。风格迁移表示的一个关键性质是解耦风格与内容:例如 Style embedding 用对比式作者验证(CAV)目标训练——以"同一作者不同主题"的文本为正例、"同一主题不同作者"的文本为负例构成训练三元组。因此我们训练 TinyStyler 以 Style embedding 为条件执行风格迁移;而训练数据更大的 UAR 嵌入则保留为留出的作者表示空间,用于作者风格迁移的自动评估(沿用 Patel et al., 2022; Horvitz et al., 2024)。
架构。为从复述与作者嵌入重建文本,我们微调修改版 T5(Raffel et al., 2020)——800M 参数。把嵌入维度(768)联合学习投影到 T5 隐层维度(1024),再把投影后的嵌入前置于输入文本的词嵌入。
训练细节。为语料中每条评论生成复述与 Style embedding:复述使用开箱 Pegasus 模型(Zhang et al., 2020;tuner007/pegasus_paraphrase),配置同 Horvitz et al. (2024)。训练 T5 以每对(复述, Style embedding)为条件重建原始评论。训练过程与超参详见附录 A.1。
3.2 生成风格迁移对
重建模型此时已可用于风格迁移:复述一段文本,以期望目标风格的 Style embedding 为条件执行重建(图 2 步骤 2)。若目标风格有多个示例文本,我们对其 Style embedding 做均值池化——这使方法能以任意数量的目标示例为条件,且无额外内存开销。该初始方案已比文本扩散去噪(Horvitz et al., 2024)或 MCMC 采样(Mireshghallah et al., 2022)更快更省,也比提示 LLM 便宜。我们利用其高效率批量生成风格迁移样例,用自动评估指标重排序、过滤低质量样本,得到高质量风格迁移合成数据集。
高质量数据集。从 Reddit MUD 数据集随机采样 k 对不重复作者对;每对选一条随机源文本,通过采样不同复述生成多个输出——Jangra et al. (2022) 发现从复述重建的模型易产生幻觉,我们假设"采样多个复述 + 重排序"可缓解幻觉。
重排序与过滤。与 Suzgun et al. (2022) 类似,我们用自动指标排序输出:采用 Patel et al. (2022) 的 Away、Towards、Sim 指标,以三者的几何平均给每次推理的每个输出打分、取最高分者;Away/Towards 用 Style embedding 计算,Sim 用 MIS(已验证与人类判断相关,Babakov et al., 2022)。随后过滤掉语义保留指标(MIS、SimCSE,Gao et al., 2022)偏低、以及 Away/Towards(Style embedding 计算)偏低的输出;多个候选存活时取排名最高者。过滤后约剩 40K 条高质量迁移对。数据集生成细节见附录 A.2.1。
3.3 在高质量样例上自蒸馏
3.2 节流程仍依赖独立复述模型生成输入——需要额外模型推理,繁琐且增加时延;重排序虽提升性能,但多候选生成同样增加推理时间与算力开销(Suzgun et al., 2022)。为消除这些限制并提升一致性,我们完全蒸馏掉重排序与复述步骤:在重建模型自身产出的高质量合成数据集上继续微调(本质是自蒸馏,Zhang et al., 2019;图 2 步骤 3)。自蒸馏时,模型以"源文本 + 目标作者的 Style embedding"为条件,直接生成经重排序与过滤得到的高质量输出。细节见附录 A.2.3。
表 1:TinyStyler 面向不同目标风格的输出示例,展示其在词汇、标点到句法结构等多种风格属性上的变换能力。
| 源文本 | 非正式 | 疑问+陈述 | 奥巴马演讲 |
|---|---|---|---|
| Toto, I've a feeling we're not in Kansas anymore. | i think we arent in Kansas anymore tbh. | We are not in Kansas anymore? I feel you. | I think we are no longer in Kansas. |
| is mayonnaise an instrument? | oh wait mayonnaise is an instrument :( | Can you tell me what mayonnaise is? It is an instrument. | This makes me wonder if mayonnaise is an instrument. |
| Life is like riding a bicycle. To keep your balance, you must keep moving. | life is like riding a bicycle so you gotta keep moving :( | Life is like riding a bicycle. Do you have to keep moving? | But life is like riding a bicycle - you must keep moving. |
| Life moves pretty fast. If you don't stop and look around once in a while, you could miss it. | life moves fast if you dont stop and look around once in a while i think. | Is this an important lesson? Life moves fast. If you don't stop and look around once in a while, you could miss it. | If you don't stop and look around once in a while, you could miss it. |
| The first rule of Fight Club is you do not talk about Fight Club. | u dont talk about fight club you know,first rule. | First rule of Fight Club? Do not talk about Fight Club. | The first rule of Fight Club is not to talk about it. |
4 评估
我们在作者风格迁移与文本属性风格迁移(正式 ↔ 非正式)两个任务上评估 TinyStyler。
4.1 低资源作者迁移
对非知名作者,其风格可用的文本可能只有几篇。低资源作者风格迁移即"在目标风格数据有限的条件下迁移到目标作者风格"的任务。我们在 Patel et al. (2022) 的数据集及其三个划分(Random、Single、Diverse)上评估:每个划分各有 15 位作为源风格的 Reddit 用户与 15 位作为目标风格的用户,每人 16 篇写作样本;每划分共 225(15×15)个迁移方向、3600(225×16)次变换。
实现细节。对目标风格示例的作者嵌入做均值池化作为条件。考察两种配置:TinyStylerrecon 为 3.2 节/图 2 步骤 2 的初始方案(从复述 + 目标风格嵌入重建);TinyStyler 为在高质量合成数据集上二次微调后的最终模型(3.3 节,蒸馏掉独立复述器)。两种配置都额外考察推理期重排序这个可选技术。虽然重排序增加算力开销,本方法整体推理时间仍低于其他方法(见附录 D)。作者迁移评估细节见附录 B.1。
指标。采用 Patel et al. (2022) 的 Away、Towards、Sim、Joint 指标。注意:重排序时 Away/Towards 用 Style embedding 计算,而评估时改用留出的 UAR 嵌入(Rivera-Soto et al., 2021)——避免直接用自动风格评估指标做重排序而虚高性能。
基线。包含 Patel et al. (2022) 实现的全部方法(含 STYLLGPT-3、STYLLBLOOM 等 LLM 方法);加入使用文本扩散模型的近期方法 ParaGuide(Horvitz et al., 2024);以及提示式 GPT-3.5、GPT-4。细节见附录 B.3。
4.2 正式度迁移
用既有 GYAFC 数据集(Rao & Tetreault, 2018)评估属性风格迁移。之所以选择正式度作为附加任务,是因为作者风格迁移对人类评估很困难(Patel et al., 2022),而正式度对标注者而言是广泛可识别的属性。
实现细节。提供正式或非正式文本的少样本示例:抽取每个目标示例的 style embedding 并均值池化作为条件。评估 num examples = 4 与 num examples = 64 两种设置。若干对比基线需要"在正式/非正式文本上训练的分类器"引导生成——我们在 GYAFC 上训练此类分类器,并用它选择 TinyStyler 的代表性少样本示例。
基线。与 ParaGuide(Horvitz et al., 2024)、Mix and Match(Mireshghallah et al., 2022)两个近期可控生成方法对比(两者推理时均由 GYAFC 训练的分类器引导),并对比 GPT-4、GPT-3.5 与朴素的 COPY 基线。
指标。迁移准确度用留出的开箱正式度分类器(Dementieva et al., 2023; Briakou et al., 2021);语义保留(Sim)用 MIS(Babakov et al., 2022);由于可控生成基线易出现不流畅(Horvitz et al., 2024; Mireshghallah et al., 2022),另用 CoLA 训练的模型计算 Fluency(Morris et al., 2020; Warstadt et al., 2019),并报告中位数 GPT-2 困惑度(另一被提议的流畅度指标,Khan et al., 2024)。聚合 Joint 指标按 Horvitz et al. (2024) 与 Krishna et al. (2020),取 Accuracy、Sim、Fluency 的几何平均。
人工评估。为验证评估与人类对迁移质量的判断足够一致,请多位标注者对多方法输出打分,以二值判断评估语义保留、流畅度与正式度。细节见附录 C。
5 结果
5.1 作者迁移
表 2 为作者迁移结果。即使不重排序、不做监督蒸馏,TinyStylerrecon 已可与其他方法竞争:该无监督方案在 Joint 指标上优于全部非 LLM 基线,Away/Towards 强,但语义保留(Sim)偏低。低 Sim 问题由精炼后的 TinyStyler 解决:自蒸馏模型 Joint 显著更高,主要得益于语义保留改善(已可与 LLM 方法相当)。TinyStyler 在 Joint 指标上优于几乎所有基线——唯一例外是在 Diverse 子集上略低于 GPT-3.5;若加推理期重排序,TinyStylerrerank(5) 进一步拉开差距,在所有评估集上优于所有方法。TinyStyler 以显著轻量的方案(参数量仅为 GPT-3.5 的约 1/200)在作者风格迁移上表现强劲。此外,消融重排序的实验证明其确实能改善语义保留。
表 2:在 Reddit MUD 样本上复现 Patel et al. (2022) 的低资源作者风格迁移评估。Away/Towards 用 UAR(Rivera-Soto et al., 2021)计算,Sim 用 MIS(Babakov et al., 2022)。最高 Joint 值加粗。
| 方法 | Random | Single | Diverse | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Away | Towards | Sim | Joint | Away | Towards | Sim | Joint | Away | Towards | Sim | Joint | |
| Copysrc | 0.00 | 0.00 | 1.00 | 0.00 | 0.00 | 0.00 | 1.00 | 0.00 | 0.00 | 0.00 | 1.00 | 0.00 |
| Copytgt | 1.00 | 1.00 | 0.00 | 0.00 | 1.00 | 1.00 | 0.00 | 0.00 | 1.00 | 1.00 | 0.00 | 0.00 |
| Capi | 0.42 | 0.02 | 0.89 | 0.17 | 0.56 | 0.01 | 0.93 | 0.07 | 0.41 | 0.01 | 0.87 | 0.08 |
| Cont | 0.20 | 0.01 | 0.91 | 0.15 | 0.22 | 0.02 | 0.97 | 0.16 | 0.21 | 0.01 | 0.93 | 0.13 |
| Synm | 0.23 | 0.02 | 0.92 | 0.17 | 0.22 | 0.01 | 0.95 | 0.10 | 0.17 | 0.01 | 0.91 | 0.07 |
| Punc | 0.23 | 0.02 | 0.93 | 0.24 | 0.25 | 0.02 | 0.97 | 0.19 | 0.26 | 0.02 | 0.90 | 0.18 |
| Emoj | 0.27 | 0.04 | 0.93 | 0.25 | 0.29 | 0.06 | 0.95 | 0.27 | 0.27 | 0.02 | 0.93 | 0.17 |
| ParaNeu | 0.78 | 0.01 | 0.58 | 0.05 | 0.91 | 0.01 | 0.60 | 0.05 | 0.87 | 0.05 | 0.53 | 0.18 |
| ParaDiv | 0.75 | 0.01 | 0.69 | 0.10 | 0.91 | 0.02 | 0.71 | 0.11 | 0.83 | 0.04 | 0.70 | 0.18 |
| Ling | 0.60 | 0.06 | 0.85 | 0.32 | 0.71 | 0.06 | 0.88 | 0.25 | 0.57 | 0.03 | 0.81 | 0.19 |
| Bert | 0.22 | 0.02 | 0.72 | 0.13 | 0.29 | 0.01 | 0.69 | 0.10 | 0.30 | 0.01 | 0.60 | 0.08 |
| Strapp=0.0 | 0.98 | 0.02 | 0.16 | 0.05 | 1.00 | 0.00 | 0.23 | 0.00 | 0.97 | 0.02 | 0.22 | 0.04 |
| Strapp=0.6 | 0.99 | 0.02 | 0.08 | 0.04 | 1.00 | 0.00 | 0.13 | 0.01 | 0.97 | 0.02 | 0.11 | 0.03 |
| Strapp=0.9 | 0.99 | 0.02 | 0.05 | 0.03 | 1.00 | 0.00 | 0.08 | 0.00 | 0.97 | 0.01 | 0.05 | 0.01 |
| PGuideλ=200 | 0.70 | 0.05 | 0.58 | 0.22 | 0.82 | 0.06 | 0.66 | 0.26 | 0.77 | 0.06 | 0.54 | 0.22 |
| PGuideλ=800 | 0.74 | 0.06 | 0.55 | 0.25 | 0.86 | 0.06 | 0.62 | 0.27 | 0.81 | 0.07 | 0.50 | 0.25 |
| PGuideλ=1500 | 0.77 | 0.06 | 0.51 | 0.25 | 0.88 | 0.06 | 0.57 | 0.26 | 0.84 | 0.08 | 0.44 | 0.25 |
| PGuideλ=2500 | 0.80 | 0.07 | 0.46 | 0.25 | 0.90 | 0.06 | 0.51 | 0.23 | 0.86 | 0.08 | 0.38 | 0.24 |
| STYLLGPT-3 | 0.78 | 0.07 | 0.45 | 0.23 | 0.91 | 0.11 | 0.48 | 0.29 | 0.87 | 0.12 | 0.44 | 0.30 |
| STYLLBLOOM | 0.70 | 0.11 | 0.54 | 0.34 | 0.86 | 0.16 | 0.57 | 0.40 | 0.76 | 0.12 | 0.58 | 0.36 |
| GPT-3.5 | 0.47 | 0.09 | 0.78 | 0.35 | 0.60 | 0.15 | 0.68 | 0.41 | 0.51 | 0.10 | 0.75 | 0.37 |
| GPT-4 | 0.76 | 0.09 | 0.71 | 0.33 | 0.85 | 0.08 | 0.72 | 0.31 | 0.83 | 0.07 | 0.68 | 0.30 |
| TStylerrecon | 0.86 | 0.15 | 0.31 | 0.32 | 0.93 | 0.15 | 0.44 | 0.37 | 0.90 | 0.13 | 0.31 | 0.28 |
| TStylerrecon,rerank(5) | 0.85 | 0.15 | 0.46 | 0.38 | 0.93 | 0.15 | 0.59 | 0.43 | 0.88 | 0.13 | 0.46 | 0.35 |
| TStyler | 0.83 | 0.13 | 0.59 | 0.40 | 0.91 | 0.13 | 0.71 | 0.45 | 0.84 | 0.11 | 0.58 | 0.36 |
| TStylerrerank(5) | 0.84 | 0.12 | 0.70 | 0.43 | 0.91 | 0.13 | 0.79 | 0.48 | 0.83 | 0.11 | 0.69 | 0.39 |
5.2 正式度迁移
表 3:GYAFC 正式度迁移的自动评估。分别报告向正式目标风格(→F)与向非正式目标风格(→I)的表现。每个指标下最优的可控方法结果加粗。
| 方法 | Acc (→F, →I) | Sim (→F, →I) | Fluency (→F, →I) | Joint (→F, →I) | GPT-2 PPL |
|---|---|---|---|---|---|
| Copysrc | 0.06 (0.10, 0.01) | 0.96 (0.96, 0.97) | 0.80 (0.71, 0.88) | 0.05 (0.09, 0.01) | 97.14 |
| 大语言模型 | |||||
| GPT-3.5 | 0.90 (0.97, 0.82) | 0.86 (0.86, 0.87) | 0.85 (0.91, 0.79) | 0.79 (0.89, 0.69) | 76.53 |
| GPT-4 | 0.95 (0.99, 0.91) | 0.89 (0.87, 0.91) | 0.84 (0.91, 0.78) | 0.85 (0.90, 0.80) | 101.43 |
| 可控文本生成方法 | |||||
| M&MDisc | 0.52 (0.12, 0.92) | 0.38 (0.37, 0.38) | 0.52 (0.52, 0.53) | 0.24 (0.06, 0.43) | 167.18 |
| M&MHam | 0.49 (0.08, 0.90) | 0.56 (0.56, 0.57) | 0.50 (0.48, 0.52) | 0.29 (0.05, 0.53) | 191.08 |
| PGuideλ=200 | 0.94 (0.91, 0.96) | 0.65 (0.61, 0.69) | 0.69 (0.68, 0.70) | 0.68 (0.64, 0.71) | 160.15 |
| PGuideλ=1000 | 0.97 (0.95, 0.99) | 0.56 (0.47, 0.65) | 0.60 (0.58, 0.63) | 0.61 (0.54, 0.68) | 280.54 |
| PGuideλ=5000 | 0.97 (0.95, 0.99) | 0.49 (0.37, 0.61) | 0.54 (0.51, 0.57) | 0.55 (0.46, 0.64) | 503.46 |
| TStyler | 0.92 (0.88, 0.97) | 0.80 (0.80, 0.81) | 0.77 (0.82, 0.72) | 0.76 (0.74, 0.79) | 111.58 |
| TStylerex=64 | 0.94 (0.90, 0.98) | 0.82 (0.81, 0.82) | 0.77 (0.83, 0.72) | 0.78 (0.77, 0.80) | 112.5 |
在自动与人工评估中(表 3、表 4),TinyStyler 在 Joint、Fluency、GPT-2 困惑度与 Sim 指标上优于全部可控基线。由于通过均值池化聚合目标风格嵌入,增加目标示例无内存开销:示例数增至 64 时 Accuracy 与 Joint 进一步提升。ParaGuide 的 Accuracy 与 TinyStyler 相当,但被评定为流畅度与语义保留显著更差。
综合所有方法,GPT-4 与 GPT-3.5 在 Joint、Sim、Fluency 上最强。LLM 在该数据集上的强势并不意外——它们训练于互联网的大部分内容(OpenAI, 2023, 2022),其中包含大量正式/非正式文本示例;GYAFC 数据或指令微调监督数据中其他正式改写示例的污染也可能抬高这些模型的表现(Sainz et al., 2023)。尽管如此,TinyStyler 在 Accuracy 与 Fluency 上仍与这些更大模型竞争;在非正式方向迁移上,其 Joint 与 GPT-4 持平。
表 4:人工标注者对 GYAFC 正式度迁移输出的评分(正式度 Accuracy / 语义保留 Similarity / 流畅度 Fluency)。Joint 按样本逐一平均。
| 方法 | Acc (→F, →I) | Sim (→F, →I) | Fluency (→F, →I) | Joint (→F, →I) |
|---|---|---|---|---|
| GPT-3.5 | 0.94 (0.96, 0.92) | 0.97 (0.96, 0.97) | 1.00 (1.00, 1.00) | 0.91 (0.92, 0.89) |
| GPT-4 | 0.95 (1.00, 0.89) | 0.97 (0.95, 0.99) | 0.99 (1.00, 0.99) | 0.91 (0.95, 0.88) |
| M&MHam | 0.48 (0.05, 0.91) | 0.26 (0.21, 0.31) | 0.42 (0.35, 0.49) | 0.11 (0.01, 0.21) |
| PGuideλ=200 | 0.88 (0.89, 0.87) | 0.48 (0.49, 0.47) | 0.84 (0.85, 0.83) | 0.39 (0.43, 0.36) |
| TStylerex=64 | 0.89 (0.80, 0.97) | 0.77 (0.67, 0.87) | 0.98 (0.96, 1.00) | 0.71 (0.56, 0.85) |
推理计时。见表 9(附录 D):TinyStyler 在单张 A100 GPU 上推理时间为亚秒级,比全部可控基线快 30 倍以上,比经 API 评估的 LLM 方法快 1.5 倍以上。这表明 TinyStyler 可随时部署于时间受限的实际应用。
5.3 风格空间中的插值
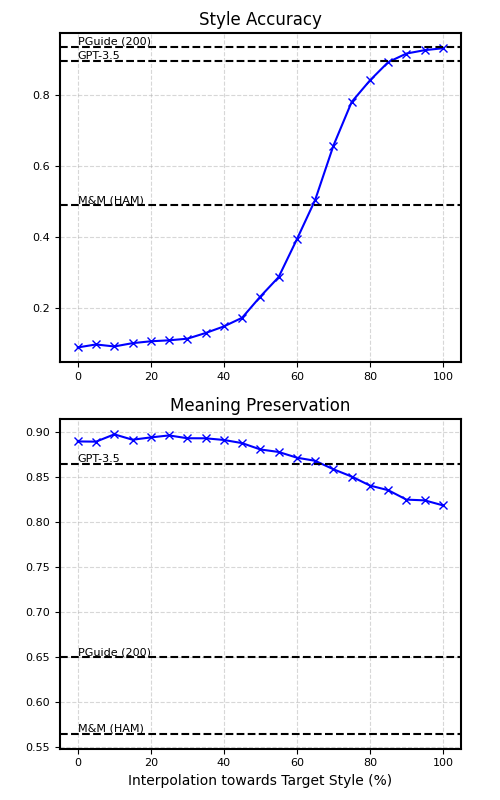
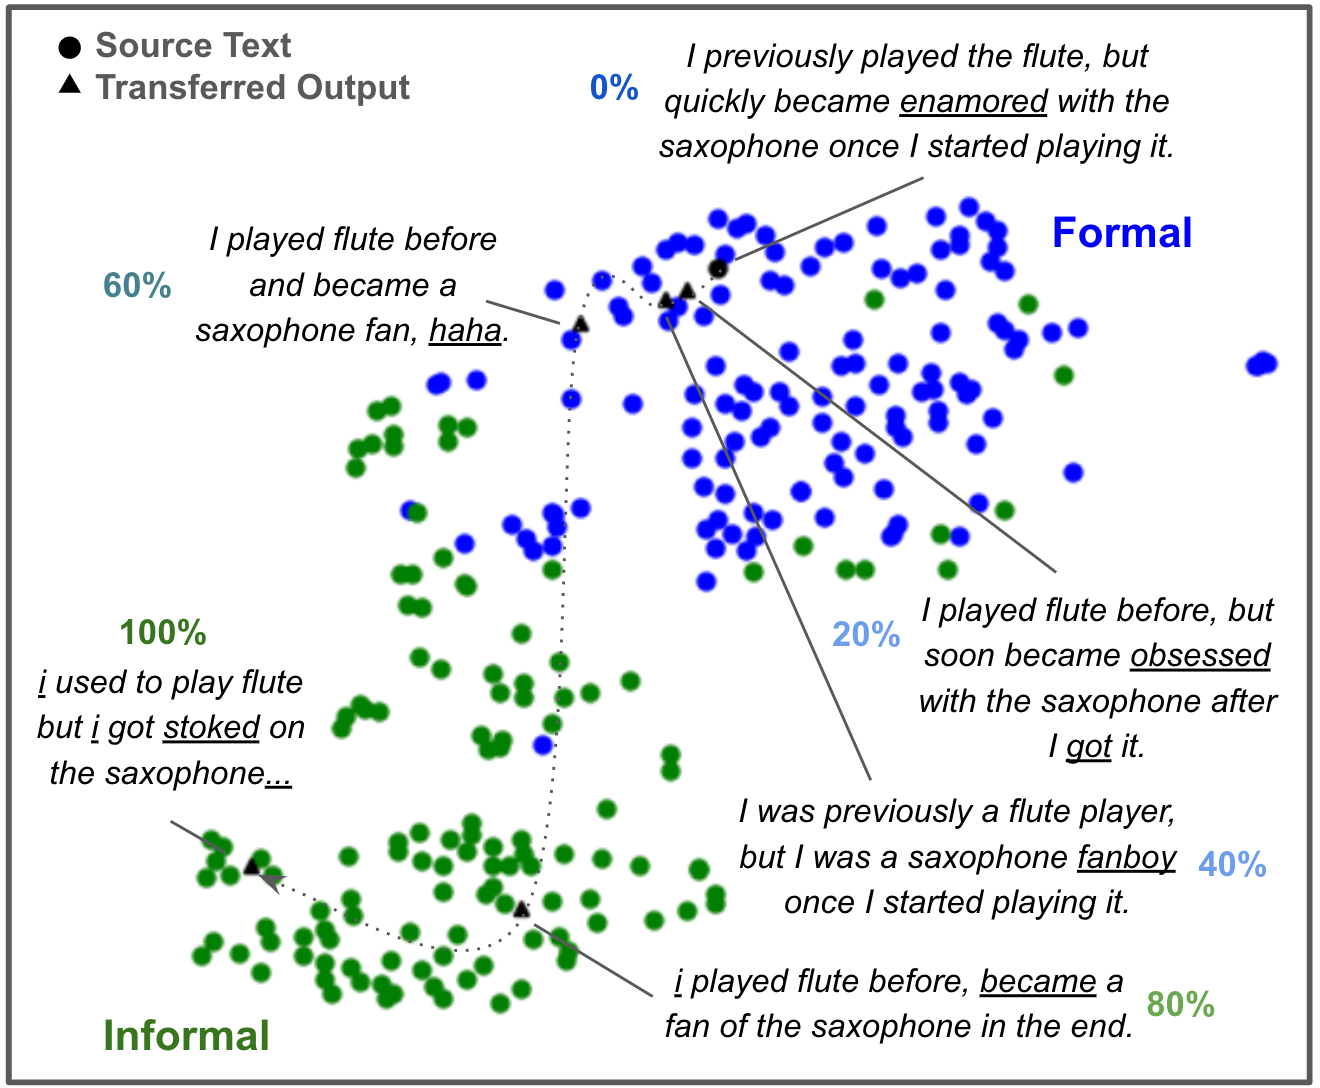
与其他可控文本生成方法(Khan et al., 2024; Horvitz et al., 2024; Mireshghallah et al., 2022)一样,TinyStyler 支持推理时指定目标风格。但相对基于提示的风格迁移,这类方法还有一项优势:直接控制"风格迁移 vs 语义保留"的权衡。图 3 可视化了在 Style embedding 空间插值对"正式 → 非正式"迁移指标的影响:远离源文本嵌入、朝向目标风格移动会提升迁移准确度,代价是语义保留下降。图 4 可视化了嵌入插值对输出文本的影响——风格空间中的移动对应着排版、词汇与句法的变化。
6 结论
我们提出 TinyStyler——一种快速、易用、高效的少样本风格迁移方法,使用小语言模型与预训练作者嵌入。在作者迁移上优于包括 GPT-4 在内的强基线;在正式度迁移上优于其他可控方法、并更具与 LLM 的竞争力。本工作凸显了独立预训练作者嵌入的效用,并期待未来出现能捕捉更丰富文本风格特征的表示。此外,TinyStyler 展示了"自动指标重排序 + 过滤 + 自蒸馏"作为训练高效模型的流程的潜在价值——这条路能使小模型与 LLM 竞争并缩小差距。我们因而对自动文本评估的进步充满期待:将其纳入风格迁移与其他生成管线,可能转化为性能收益。
局限。TinyStyler 依赖预训练作者嵌入:它既能受益于作者风格表示学习的持续进步,也被其当前的表示能力所制约。因此 TinyStyler 可能在 Style embedding 未捕捉的较罕见风格特征(如五步抑扬格)上表现欠佳;此外,作者风格迁移指标也可能无法完全反映人类作者的偏好。
伦理考量。TinyStyler 是一种高效的少样本风格迁移方法,资源消耗远低于其他基于 LLM 的方法。因此它既能赋予个人与组织改写文本、或把聊天模型的通用输出个性化到用户偏好的能力;同时,高效的文本风格迁移也可能帮助恶意行为者进行冒名。据此,文本风格迁移研究值得重新聚焦 AI 生成文本检测,并投入更广泛公众的媒介素养教育。
致谢(节选):感谢参与人工评估的同事、匿名审稿人;本研究部分受 ODNI / IARPA HIATUS 项目(合同号 2022-22072200005)资助。
附录
附录 A:TinyStyler 细节
A.1 风格重建训练
A.1.1 数据集。训练与验证集取自公开的 Reddit MUD 数据集(Khan et al., 2021):每个用户随机采样 40 条评论,用 Pegasus 分词器(Zhang et al., 2020)过滤超过 128 token 的评论,共约 440 万条文本。用户按 95/2.5/2.5 划分 train/validation/test,并确保评估数据集中的作者不出现在训练作者集合中。
A.1.2 复述与 Style embedding 生成。复述使用流行的开箱 Pegasus 复述模型(tuner007/pegasus_paraphrase),复述模型与推理超参同 ParaGuide(Horvitz et al., 2024):在 size=10 的束搜索上做核采样(Holtzman et al., 2020,top-p / temperature 设置同原文)。用公开 checkpoint 与推理逻辑(AnnaWegmann/Style-Embedding)为 440 万条样本提取 Style embedding(Wegmann et al., 2022)。
A.1.3 架构。修改 T5-Large(google/t5-v1_1-large,约 800M 参数)以"输入文本 + Style embedding"为条件:把 Style embedding 从 768 维投影到模型嵌入维度 1024,并前置于输入词嵌入。
A.1.4 训练超参。在 NVIDIA A100 上按表 5 超参微调;未做大量超参搜索,沿用既有工作的学习率与批大小(Horvitz et al., 2024)。模型被训练为"从复述与 Style embedding 重建原始评论",Style embedding 投影与其余参数联合学习。
表 5:TinyStylerrecon 的微调超参数。
| 超参数 | 取值 |
|---|---|
| 预训练检查点 | google/t5-v1_1-large |
| 学习率 | 1×10⁻⁵ |
| 批大小 | 16 |
| 梯度累积 | 4 |
| 优化器 | Adam |
| 权重衰减 | 0.01 |
| 调度 | 恒定 |
| 预热步数 | 2000 |
| 总步数 | 230,000 |
A.2 自蒸馏细节
A.2.1 用 TinyStylerrecon 生成数据。构建"高质量数据集"的流程:1)从训练数据随机采样 50k 个不重复的(源, 目标)作者对;2)每个源作者采样一条源文本;3)每条源文本生成 14 个复述(同 A.1.2);4)对每个复述,采样目标作者的 4 条文本、提取 Style embedding 并均值池化;5)用这 14 对(复述, Style embedding),以温度/采样设置同原文,从 TinyStylerrecon 采样 8 个对应输出。
A.2.2 过滤。对 50k 作者对的每个(共 112 个)候选输出:1)先过滤与输入完全相同、以及含幻觉链接(正则规则)的候选;2)过滤语义保留分数低的候选——用 MIS(Babakov et al., 2022)与 SimCSE(Gao et al., 2022,分数归一化后),经人工检视示例后两模型阈值均取 0.7;3)再过滤迁移准确度低的候选——Away/Towards 用 Style embedding 计算,要求 Away ≥ 0.5 且 Towards ≥ 0.1;4)多个候选存活时,选使 Away·Towards·Sim(此处 Sim 不做归一化,与 Patel et al., 2022 不同)最大的输出。最终得到约 40k 条高质量样例。
A.2.3 TinyStyler 的微调。从 A.1 的模型出发,在高质量数据集上继续训练:跳过复述,直接以"源文本 + 目标作者全部文本"为条件,其余超参同表 5。选择验证损失最低的检查点。
附录 B:评估细节
B.1 作者迁移。在 Patel et al. (2022) 数据集的三个划分上评估:Random(随机源/目标作者);Single(所有帖子来自某热门大学橄榄球子版块);Diverse(源/目标作者帖子横跨 13 个以上不同子版块)。每划分 15 位源作者与 15 位目标作者,且所有评估作者均排除在训练数据之外。TinyStylerrecon:采样 14 个复述,每个复述采样目标作者 4 条文本提取 Style embedding,为每个(复述, Style embedding)对生成输出,选 Away·Towards·Sim(Style embedding 计算,而非 UAR)最高者;TinyStylerrecon(无重排序)取第一个结果。TinyStyler:以源文本 + 目标作者全部 16 个示例为条件;若加重排序则采样 8 个输出、同样选聚合分数最高者。
B.2 正式度迁移。使用 GYAFC 的娱乐与音乐子集(Rao & Tetreault, 2018),含 1000 条正式与 1000 条非正式原始样本。Accuracy 用留出的开箱模型(s-nlp/xlmr_formality_classifier,训练于 XFormal,Dementieva et al., 2023; Briakou et al., 2021);Fluency 用 CoLA 训练模型(textattack/roberta-base-CoLA,Morris et al., 2020; Warstadt et al., 2019)。内部形式度分类器:以表 6 超参在 85% GYAFC-EM 训练集上微调 roberta-base(Liu et al., 2019),余下训练样本做验证。
表 6:用于 Mix & Match 与 ParaGuide 基线的内部形式度分类器微调超参数。
| 超参数 | 取值 |
|---|---|
| 预训练检查点 | roberta-base |
| 学习率 | 5×10⁻⁵ |
| 批大小 | 128 |
| 优化器 | Adam |
| 权重衰减 | 0.01 |
| 调度 | 恒定 |
| 总步数 | 2700 |
内部分类器用于 ParaGuide 与 M&M 的引导;也用于挑选每类高概率(≥0.9)示例作为 LLM 方法与 TinyStyler 的示例。从 GYAFC Tune 集随机选 100 个正式/非正式示例;TinyStyler、GPT-4、GPT-3.5 每次推理从中采样 4 个;TinyStylerex=64 每次采样 64 个。
B.3 基线细节。作者迁移用 Patel et al. (2022) 的基线;ParaGuide 通过微调公开的 SSD-LM 检查点(xhan77/ssdlm,Li et al., 2022)在附录 A.2.1 的数据集上复现(输入/输出长度扩至 80,其余超参用原论文;见表 7);M&M 用原论文 Hamming 与 Disc 配置、基座语言模型用 RoBERTa-Large。所有 TinyStyler 与基线实验的总算力预算估计约 2700 GPU 小时。最后,用附录 E 的提示词对 GPT-3.5(gpt-3.5-turbo-0125)与 GPT-4(gpt-4-turbo)做作者与正式度迁移。
表 7:ParaGuide 基线的微调超参数。
| 超参数 | 取值 |
|---|---|
| 预训练检查点 | xhan77/ssdlm |
| 学习率 | 5×10⁻⁶ |
| 批大小 | 64 |
| 梯度累积 | 2 |
| 优化器 | Adam |
| 权重衰减 | 0.01 |
| 调度 | 恒定 |
| 扩散步数 | 200 |
| 上下文/输出长度 | 80 / 80 |
| 预热步数 | 2000 |
| 总步数 | 2,000,000 |
附录 C:人工评估
为每种方法对 600 个示例(400 正式→非正式、200 非正式→正式)生成输出;招募 17 位英语母语者(均为研究生志愿者),每例分配 3 位标注者,按多数投票定标签;标注指令见附录 F。标注者间一致性(Krippendorff's α)见表 8。
表 8:标注者间一致性(Krippendorff's α)。
| 标签 | Krippendorff's α |
|---|---|
| 语义保留(Meaning Preservation) | 0.55 |
| 流畅度(Fluency) | 0.58 |
| 正式度(Formality) | 0.61 |
附录 D:计时
表 9:"正式 → 非正式"任务的计时信息(n = 200)。
| 方法 | 秒/次 |
|---|---|
| GPT-3.5 | 0.70 |
| GPT-4 | 1.56 |
| M&MDisc | 69.3 |
| M&MHam | 68.2 |
| PGuideλ=200 | 17.72 |
| TStyler | 0.47 |
| TStylerex=64 | 0.43 |
附录 E:提示词(用于 GPT-3.5 / GPT-4)
E.1 作者迁移(通过 OpenAI chat completions API):
message = 'The following comments are written by a single author: \n'
for i, text in enumerate(examples):
    message += json.dumps({'text': text}) + '\n'
message += "\n\nCan you rewrite the following comment to make it look like the above author's style:\n"
message += json.dumps({'text': original_text}) + '\n'
client.chat.completions.create(
  model=model_name,
  response_format={"type": "json_object"},
  messages=[
    {"role": "system", "content": "You are a helpful assistant designed to output JSON."},
    {"role": "user", "content": message}])
E.2 正式度迁移:
message = f'The following texts are written in {target_style} style: \n'
for i, text in enumerate(examples):
    message += json.dumps({'text': text}) + '\n'
message += f"\n\nCan you rewrite the following text to make it look like the above {target_style} style:\n"
message += json.dumps({'text': original_text}) + '\n'
client.chat.completions.create(
  model=model_name,
  response_format={"type": "json_object"},
  messages=[
    {"role": "system", "content": "You are a helpful assistant designed to output JSON."},
    {"role": "user", "content": message}])
附录 F:人工评估指令(英文原文)
注意:示例直接选自 GYAFC(Rao & Tetreault, 2018),其中包含冒犯性内容。
Each annotator has been assigned a series of very short texts to review. Each example consists of a reference and output text.
We would like you to evaluate the output text across three criteria:
1) Similarity to the reference. Is the meaning of the reference preserved by the output? (0= No, 1= Yes)
2) Well-formedness / Fluency. Does the output look like a text that could reasonably appear on an internet forum? Is it coherent? (0= Badly-Formed, 1= Well-formed)
3) Formality. Is the output text informal or formal? (0= informal, 1= formal)
Empty outputs can be marked with all 0s.
Please avoid consulting other annotators / annotations.
正式文本示例(节选):"I like Rhythm and Blue music."、"There's nothing he needs to change."、"It does not exist." …
非正式文本示例(节选):"Is Any Baby Really A Freak."、"You can get almost anything on ebay!"、"I want to be on TV!" …